1本の動画を生成単位に切り分ける:ショットリストの作り方と書き方
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
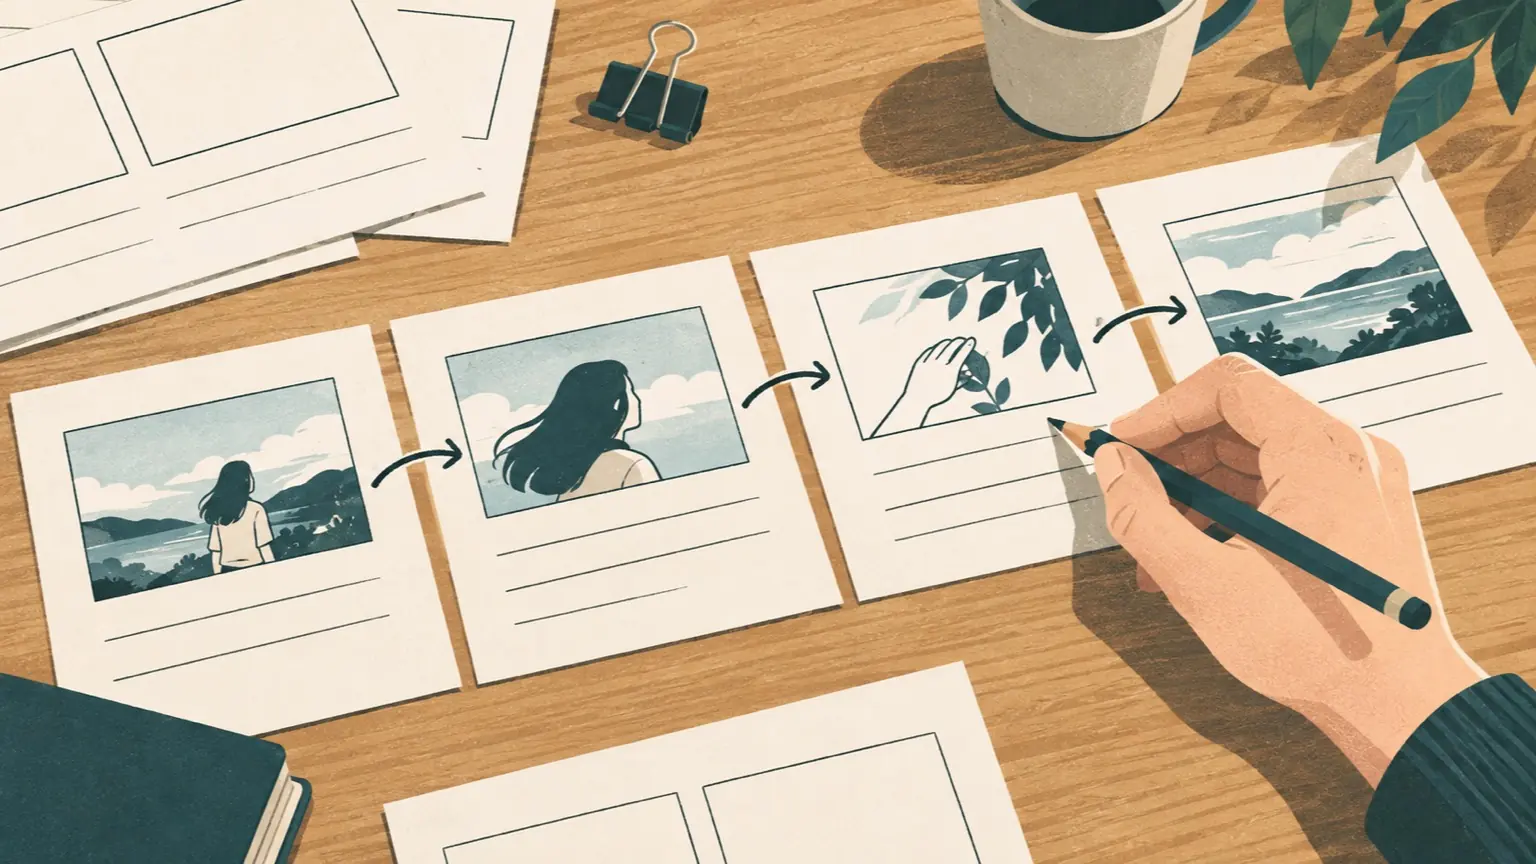
結論から言うと、切り分けの基準は「1ショットに、目的を1つ、主役の被写体を1つ、主な動きを1つだけ持たせる」ことです。この3つのどれかが2つ以上になったら、そこで分けます。長さは、使うツールが一度に作れる秒数(後述)に収まるようにし、それぞれのショットを「目的・被写体・動き・つなぎ方」の列を持つ一覧表に書き出します。この記事では、その表の作り方と、AIに下書きさせる依頼文、人が確認する点までを扱います。
この記事の目次
まず、生成単位の上限を確認する
ショットの長さは、ツールの仕様から逆算します。2026年10月27日に私が開いた公式ページでは、次のように書かれていました。
- Runway Gen-4 は5秒または10秒の動画を作ります。入力画像が出力動画の最初のフレームになり、テキストでは主に動きを書く設計です。プロンプトは1000文字までと案内されています(Creating with Gen-4 Video)。
- Google の Veo 3.1 のページでは、動画生成や音声生成などの機能が紹介されています。出力時間や参照画像、延長、フレーム指定などの条件は、利用する製品・機能の現行ページで確認してください。(Veo – Google DeepMind)
秒数、対応機能、料金、プランはよく変わります。実際に作る前に、使うツールの現行ページで確認してください。以降は「1ショット=5〜8秒前後」を前提に説明します。
手順1:全体を「見せたいこと」の単位に分ける
最初はまだ映像のことを考えず、動画で伝える内容を文にします。1文に1つの情報だけ入れます。
説明用の例(架空の商品です):折りたたみ式水筒「ポケボトル」の30秒紹介動画。
- 通勤かばんの中で、水筒がかさばって困る。
- ポケボトルは畳むと手のひらサイズになる。
- 畳む動作を見せる。
- 広げて水を注ぐ。
- 公園のベンチで使う。
- 商品名と締めの一言。
この6文が、ショット候補の数になります。30秒を6つに分けると、1ショットは平均5秒です。
手順2:分割の判断表で、分けるか残すかを決める
1つの候補に複数の要素が入っているときは、次の表で判断します。これは生成の失敗を減らすための編集上の目安で、公式の仕様ではありません。
- 場所が変わる、判断:分ける、理由:背景を丸ごと作り直すことになる
- 主役の被写体が変わる、判断:分ける、理由:見た目の一貫性を保つ対象が増える
- 動きが「Aしてから Bする」と2段階、判断:分ける、または長い方の秒数を使う、理由:Runwayの案内では、複数の動きは10秒向きとされる
- カメラが動き、かつ被写体も大きく動く、判断:片方に絞る、理由:何が動いたのか分からない映像になりやすい
- 画面内の文字や数字を読ませたい、判断:生成に任せず編集ソフトで重ねる、理由:文字は後から正確に差し込めるため
- 同じ構図で表情や小物だけ変わる、判断:残す、理由:目的が同じなら1ショットで足りる
「動きが2段階」の秒数は一律には決められません。Runway Gen-4の案内では、複数の動きを含むプロンプトには10秒が向くとされていますが、これは同モデルの説明です。使用するツールの現行仕様と生成結果を見て決めてください。(Creating with Gen-4 Video)
手順3:一覧表に書き出す
説明用の例として、先ほどの6文を一覧表にします。実際に生成して確かめたものではありません。
- 1、秒数:5、目的:困りごとの共感、被写体:通勤かばんと膨らんだ水筒、動き:かばんを肩にかけ直す。カメラは固定、つなぎ方:次のショットへカット(切り替え)
- 2、秒数:5、目的:解決策の提示、被写体:手のひらに載った畳んだ水筒、動き:手を少し上げて見せる。カメラはゆっくり寄る、つなぎ方:手の位置を合わせて次へ
- 3、秒数:5、目的:仕組みを見せる、被写体:水筒本体、動き:畳んだ状態から広がる。カメラは固定、つなぎ方:広がった水筒の形で次へ
- 4、秒数:5、目的:使い方の具体化、被写体:水筒とコップ、動き:水を注ぐ。カメラは固定、つなぎ方:注ぎ終わりでカット
- 5、秒数:5、目的:利用場面、被写体:ベンチの人物と水筒、動き:水筒を口に運ぶ。カメラは右へ小さくパン、つなぎ方:風景のぼかしで次へ
- 6、秒数:5、目的:締め、被写体:商品全体、動き:動きは最小限、つなぎ方:文字を編集ソフトで重ねる
列の書き方のコツは次のとおりです。
- 目的:視聴者に何を理解してほしいかを1行で書きます。「かっこいい映像」では判断できないので、「共感」「提示」「仕組み」のように役割で書きます。
- 被写体:見た目を固定したい対象を、毎回同じ言い方で書きます。表現がぶれると、生成のたびに別物になりやすくなります。
- 動き:被写体の動きとカメラの動きを分けて書きます。「カメラは固定」と明記すると、あとで見直しやすくなります。
- つなぎ方:カット、動作の継続、構図の一致など、前後をどう接続するかを書きます。
手順4:つなぎ方に合わせて生成方法を選ぶ
つなぎ方の列は、そのまま生成方法の指示になります。
- カットで切り替える場合:ショットごとに別の画像や指示で作れます。ただし、人物や商品の見た目は揃える必要があります。Runwayの「長い動画の作り方」の案内では、一貫性のために、人物を複数の角度から見せた基準画像(キャラクタープレート)や、環境の基準画像を先に作ることが勧められています(How to create longer videos and films)。同じページでは、物語を5〜10秒のショットに分けて詳しく書く絵コンテも勧められています。
- 動作を引き継ぐ場合:前のショットの最後のコマを、次のショットの最初の画像に使う方法が考えられます。Runway Gen-4 は入力画像を最初のフレームにします。前後のショットが自然につながるかは、生成して確認してください。
- 文字を入れる場合:生成ではなく、編集ソフトで重ねる想定にします。
手順5:AIに下書きを作らせる依頼文
一覧表の下書きはチャットAIに任せられます。次の依頼文は説明用で、そのまま使えるよう空欄を括弧で示しています。
次の動画を、動画生成AIで作るためのショットリストに分けてください。

【動画の内容】(例:折りたたみ式水筒の30秒紹介)
【伝えたいこと】(1文ずつ、箇条書きで)
【使う生成ツールの1回の長さ】(例:5秒または10秒)
【条件】
- 1ショットに、目的は1つ、主役の被写体は1つ、主な動きは1つだけ
- 場所が変わる、または主役が変わるときは必ずショットを分ける
- 画面内の文字は生成せず、編集で重ねる前提にする
- 各ショットの合計が(30)秒前後になる
【出力形式】
表。列は「番号・秒数・目的・被写体・動き(被写体とカメラを分ける)・つなぎ方」
最後に、被写体の見た目を固定するための共通の説明文を1つ作る
商品名、顧客情報、未公開の企画などをそのまま貼る必要はありません。仮の名前や架空の数値に置き換えて作り、あとで差し替えます。
手順6:人が確認する4点
AIが出した表は、次の点を人が見て直します。
- 1ショット1動きになっているか:「注いでから飲む」のように動きが2つ入っていないか確認します。
- 秒数が上限に収まっているか:使うツールの現行仕様に合わせます。
- 被写体の説明が全ショットで同じ言葉か:別の言い方が混ざっていたら統一します。
- つなぎ方が実際に作れるか:「構図を合わせて次へ」と書いても、画像の用意なしでは作れません。
最後に、最初の2ショットだけ生成して並べて見ます。見た目がずれるなら、全6本を作る前に被写体の説明や基準画像を直します。生成にはクレジットなどの消費があるため、少数で確かめてから進める方が無駄が出ません。Runwayは、低コストのTurboモデルで先に試す方法を案内しています(Creating with Gen-4 Video、前掲)。
ショットリストのひな形
最後に、コピーして使える空の表です。
- 1、秒数:、目的:、被写体:、動き(被写体/カメラ):、つなぎ方:
- 2、秒数:、目的:、被写体:、動き(被写体/カメラ):、つなぎ方:
- 3、秒数:、目的:、被写体:、動き(被写体/カメラ):、つなぎ方: