自由回答を読み解く:AI要約に頼る前に、元の言葉を残す整理のしかた
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
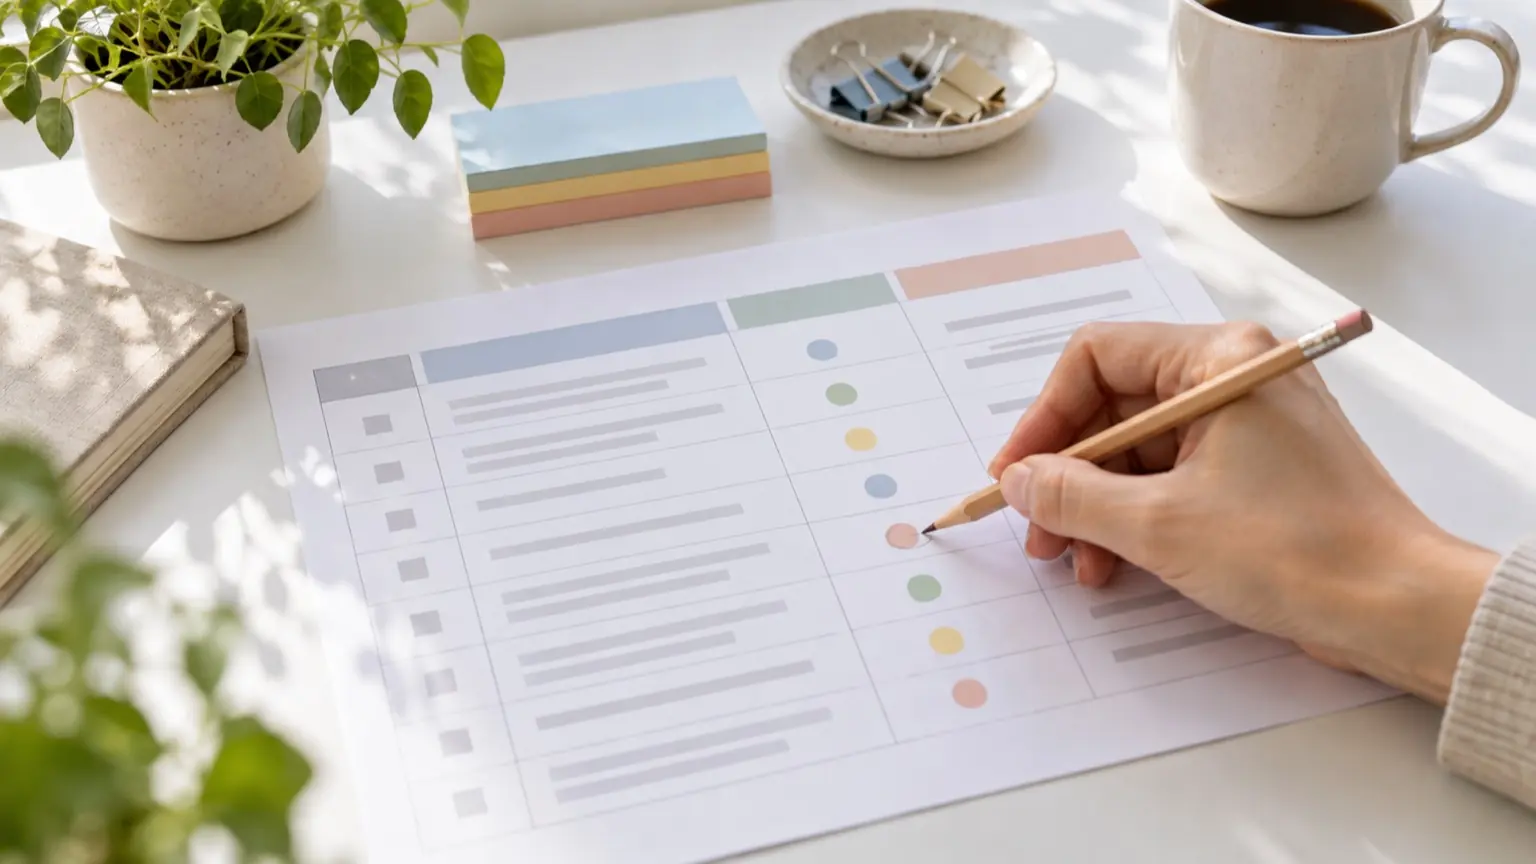
自由回答をAIで扱うときは、要約を先に作らず、原文を1件ずつIDつきで残した「整理シート」を先に作ります。AIには要約ではなく、1件ごとのテーマ分けの案と、引用に向く箇所の候補出しを任せます。最終的な要約は、そのシートの件数と原文に照らして人が確かめます。 この順番にする理由は単純です。要約は「多くの人が言っていること」を中心にまとまるので、1〜2件しかない指摘や、短くても強い言葉が落ちやすくなります。落ちたかどうかは、要約文だけを見ても分かりません。原文とテーマが手元に並んでいれば、後から照合できます。 この記事で扱うのは、アンケートの自由記述欄や問い合わせ文など、数十〜数百件のテキストをテーマ分けして社内に伝える場面です。統計的な代表性の判断や、調査設計そのものは扱いません。
この記事の目次
全体の流れ
- 原文を加工せず保存し、IDを振る
- 個人が特定される情報を置き換えた作業用の列を作る
- 人が少数件を読み、仮のテーマ表を作る
- AIにテーマ分けの案を出させる
- 少数意見と強い言葉を別の列で拾う
- 要約を作り、確認観点で原文と突き合わせる
この手順は、公的統計で使われる「アフターコード方式」と共通点があります。総務省統計局の社会生活基本調査の説明では、回答者が自由に記入した内容を、集計段階で分類基準に従ってコード化する方式と説明しています。分類区分を細かく設定でき、生活行動を詳しく把握できる一方、プリコード方式より記入や分類格付けなどの事務が多いとされています。自由回答の整理でも、原文を残してから分類する順序が参考になります。以下の列構成や判断基準は、この考え方を実務向けに組み直した編集上の提案です。
整理シートの形
列は次のとおりです。スプレッドシートでもCSVでも構いません。
- ID、内容:R001のような連番。並べ替えても原文と結びつく、誰が書くか:人
- 原文、内容:受け取ったまま。誤字も直さない、誰が書くか:人(貼り付けのみ)
- 作業用テキスト、内容:氏名・電話番号・住所などを置き換えたもの、誰が書くか:人
- テーマ(案)、内容:最大2つまで。当てはまらなければ「未分類」、誰が書くか:AIが案、人が確定
- 強い言葉、内容:原文から抜いた短い語句(「二度と」「がっかり」など)、誰が書くか:AIが案、人が確定
- 少数意見フラグ、内容:他に似た回答が少ないが残したい指摘、誰が書くか:人
- 引用候補、内容:原文の一部。一字一句そのまま、誰が書くか:AIが案、人が原文と照合
- 確認メモ、内容:文脈が読み取れない点、追加で聞きたい点、誰が書くか:人
以下は説明用の例です。実在の調査ではなく、架空の食材宅配サービスの感想として私が作った文です。
- R001、作業用テキスト:野菜は新鮮だったが、量が多くて使い切れなかった、テーマ(案):量・使い切り、強い言葉:使い切れなかった、少数:、引用候補:量が多くて使い切れなかった
- R002、作業用テキスト:届く時間帯が選べず、在宅の予定を空けるのが大変、テーマ(案):受け取り、強い言葉:大変、少数:、引用候補:在宅の予定を空けるのが大変
- R003、作業用テキスト:箱が大きすぎて、毎回ごみの処理に困る、テーマ(案):梱包・ごみ、強い言葉:困る、少数:、引用候補:毎回ごみの処理に困る
- R004、作業用テキスト:説明書の文字が小さく、読むのを諦めた、テーマ(案):説明書の見やすさ、強い言葉:諦めた、少数:○、引用候補:読むのを諦めた
- R005、作業用テキスト:二度と頼まない。連絡なしで届かなかった日があった、テーマ(案):受け取り/連絡、強い言葉:二度と頼まない、少数:○、引用候補:連絡なしで届かなかった日があった
- R006、作業用テキスト:量は多いが、家族が多いので助かっている、テーマ(案):量・使い切り、強い言葉:助かっている、少数:、引用候補:
R004とR005は、似た回答が例の中に1件ずつしかありません。件数で見れば埋もれますが、R005は離脱を示す言葉と、運用上の不備の具体的な事実を含みます。このような行を「少数意見フラグ」で別に管理するのが、この列の目的です。
R006のように、同じテーマでも評価が逆の回答があります。テーマ名は「量が多い」ではなく「量・使い切り」のように評価を含まない名前にしておくと、肯定と否定を同じ箱で比べられます。
手順1〜2:原文を守り、機密を置き換える
原文列はコピーを取ったうえで、触らない列として固定します。AIに渡すのは作業用テキストの列です。
入力前に、氏名、連絡先、注文番号、個人を特定できる自由な記述(勤務先、家族構成の細部など)を「[氏名]」「[地名]」のような記号に置き換えます。自社の個人情報の取り扱いルールがある場合は、それが優先です。
ここで混同しやすいのが、「学習に使われない設定」と「秘密が守られること」の違いです。
- OpenAIのヘルプによると、個人向けプラン(Free、Plus、Pro)では、コンテンツがモデルの学習に使われる場合があります。ChatGPTの設定で「Improve the model for everyone」をオフにするか、Privacy Portalでオプトアウトすると、新しい会話はモデル改善に使われないと説明されています。一方、ChatGPT Business、Enterprise、Edu、APIの入力・出力は、既定では学習に使われないとされています。ただし、個人向けプランでオプトアウト後に評価ボタンからフィードバックを送ると、関連する会話全体が学習に使われる場合があります(How your data is used to improve model performance、2026年10月27日に閲覧)。
- Claudeのヘルプは、消費者向け製品について、財務情報、医療情報、認証情報、機密文書などの機微な情報を共有する際は慎重になるよう案内しています。チャットのモデル改善利用を許可した場合、レビュー前にユーザーIDとの紐づけを外す一方、安全性の分類器が検知した会話は、信頼・安全性の改善などに使われる場合があるとも説明されています(I would like to input sensitive data into my chats with Claude、2026年10月27日に閲覧)。
どちらも、プランや設定で扱いが変わる記述です。学習利用をオフにしても、その内容を外部サービスに送ること自体は変わりません。社外に出せないデータは、置き換えても出せないと判断したなら入力しない、というのが安全側の運用です。
手順3:人が先に仮のテーマ表を作る
AIにいきなりテーマを作らせると、一般的で当たり障りのない分類になりがちです。最初に人が、ランダムに20〜30件(全体が少なければ全件)を読み、仮のテーマを5〜10個書き出します。件数はあくまで目安です。
各テーマには、名前に加えて「このテーマに入れる回答の条件」を一行で書きます。たとえば次のようにします。
- 受け取り:配達の時間帯、不在、届かなかったこと
- 梱包・ごみ:箱、緩衝材、処分の手間
- 未分類:どのテーマにも当てはまらない、または意味が読み取れない
「未分類」を最初から用意するのがポイントです。ないと、AIが無理に近いテーマへ押し込みます。
手順4:テーマ分けの依頼文
次の依頼文は、先ほどの例を想定した未実行の雛形です。実際のデータで、まず10件ほど試して出力形式が崩れないか確かめてから、件数を増やしてください。1回に渡す件数は、使うツールの出力が途切れない範囲で調整します。
以下は自由回答の一覧です。各行は「ID | 作業用テキスト」の形式です。
あなたの仕事は、要約ではなく、1件ずつの分類案を出すことです。

【テーマ表】
- 量・使い切り:量の多さ・少なさ、食べ切れたか
- 受け取り:配達時間、不在、届かなかったこと
- 梱包・ごみ:箱、緩衝材、処分の手間
- 説明書の見やすさ:文字、図、読みやすさ
- 未分類:どれにも当てはまらない、または意味が読み取れない

【ルール】
1. 各IDに、テーマを最大2つ付けてください。無理に当てはめず、迷ったら「未分類」にしてください。
2. 「強い言葉」は、原文にある語句をそのまま抜いてください。言い換えや補足はしないでください。
3. 「引用候補」は、原文の連続した一部を、一字一句変えずに抜いてください。
4. 表のどれにも近くない指摘、または他に似た回答がなさそうな指摘には「少数候補」と記してください。
5. 原因や回答者の気持ちを推測して書かないでください。
6. 出力は「ID | テーマ | 強い言葉 | 引用候補 | 少数候補 | 迷った点」の表のみ。件数は入力と同じにしてください。

【データ】
R001 | …
R002 | …
出力の最後に、IDの件数が入力と合っているかを確認します。抜けや重複が出たときは、その範囲だけ再依頼します。
手順5:少数意見と強い言葉を残す基準
AIの「少数候補」は参考で、残すかどうかは人が決めます。判断の目安を表にします。これは編集上の提案です。
- 安全性、事実と異なる表示、個人情報の扱いに触れている、扱い:件数にかかわらず別枠で残し、担当部署に共有する
- 解約・乗り換えなど、行動の意思を示している、扱い:少数フラグを付け、原文のまま引用候補に入れる
- 運用上の具体的な事実(日付、場面)が含まれる、扱い:少数フラグを付け、確認メモに「追加確認が必要か」を書く
- 強い言葉だが、内容が他の回答と同じ、扱い:テーマには数えるが、強い言葉の列にも残す
- 意味が読み取れない、扱い:「未分類」にして推測で補わない
強い言葉は、頻度よりも「どの場面で出たか」が重要です。「二度と」が1件あっても、その前後の事実(R005では連絡なしの未着)とセットで報告すれば、対策の議論に使えます。
手順6:要約の確認観点
テーマ別の件数をシートから数え、そのうえで要約を書きます。AIに要約を頼む場合は、「件数表とIDつきの引用候補だけを根拠にすること」と条件を付けます。出てきた要約は、次の観点で確認します。
- 件数:要約中の「多くの」「一部の」「少数の」が、シートの件数と対応しているか。割合を書く場合は分母を明記しているか
- 根拠ID:すべての主張に、少なくとも1つの回答IDが付いているか。IDがない主張は、原文から探して裏づけを取るか削る
- 引用の一致:かぎかっこの文が、原文と一字一句一致しているか。検索やコピー比較で確かめる
- 評価の向き:「量が多い」が肯定か否定かなど、反転や条件の脱落がないか(R001とR006のように、同じ話題で逆の評価がある)
- 推測の混入:回答にない原因や意図(「価格に不満があるのだろう」など)が書き足されていないか
- 少数の保存:少数フラグ付きの行が、要約か別枠のどちらかに残っているか
- 未分類:未分類の件数と内容が、報告のどこかで触れられているか
確認の途中で原文と食い違いを見つけたら、直すのは要約ではなくシートです。シートの該当行を直し、そこから要約を作り直すと、次回以降も同じ失敗が起きにくくなります。
報告に載せる最小セット
社内に渡す資料は、次の3点があれば足ります。
- テーマ別の件数表(未分類を含む)
- テーマごとに1〜3件の引用(ID付き)
- 少数フラグの行を別枠にまとめた一覧
要約文はこの3点の読み方を添える程度にとどめます。読み手が疑問を持ったときに、IDから原文へ戻れることが、この整理の価値です。