「探せたか」と「答えたか」を分けて採点する:RAG評価の2段階の見方
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
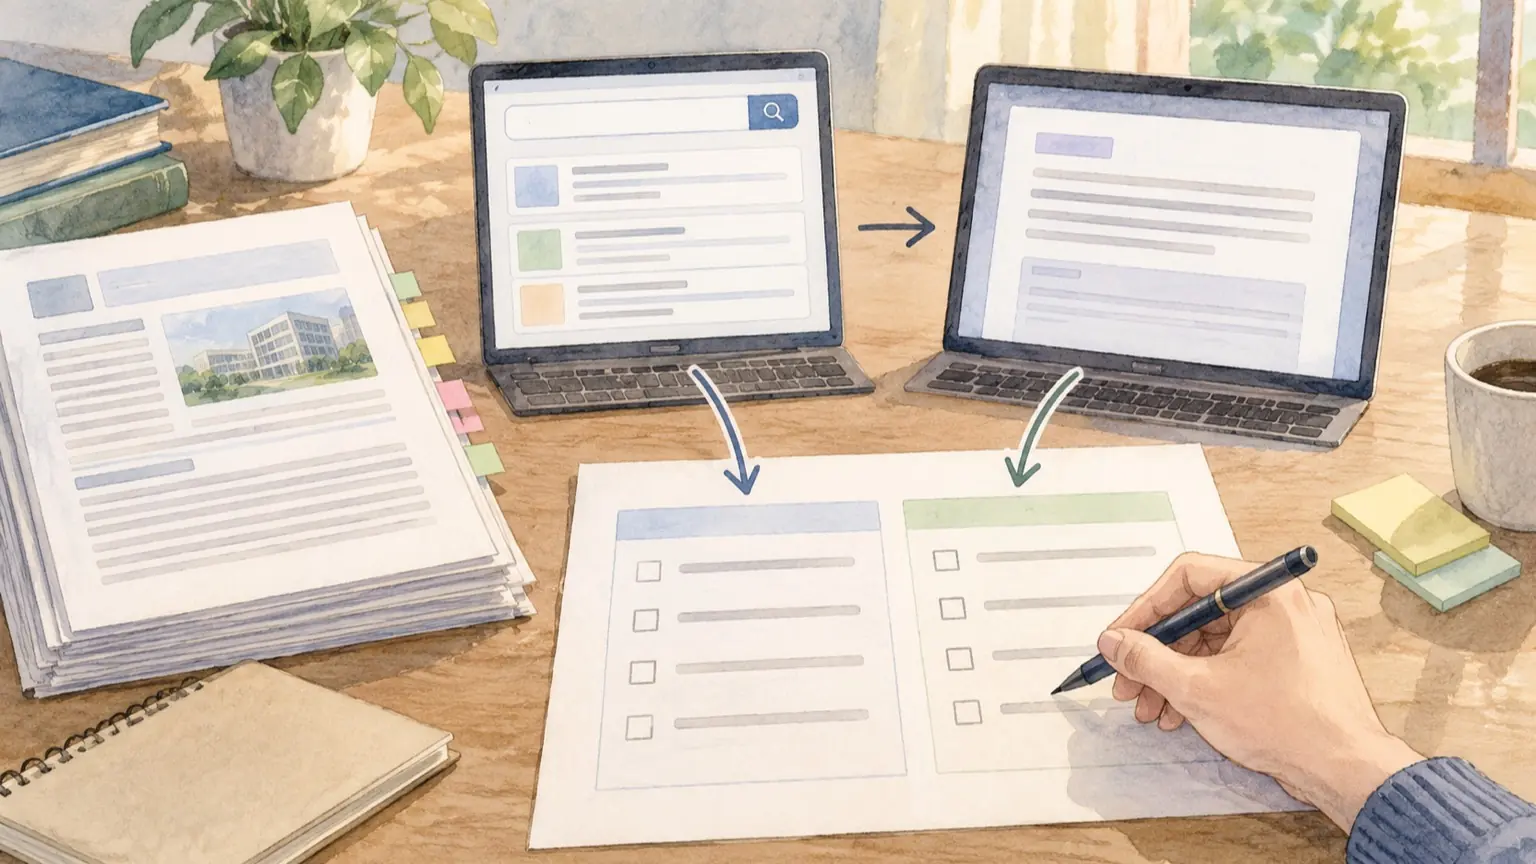
結論から言うと、RAG(資料を検索してAIに答えさせる仕組み)の評価は「回答が良いか悪いか」の1本では足りません。まず検索の段階で正しい根拠が取れたかを判定し、次に回答の段階でその根拠に沿って答えられたかを判定します。2つを掛け合わせると、「検索を直すのか、回答の指示を直すのか、そもそも資料が足りないのか」が判断できます。 回答だけを見ていると、間違った答えが出たとき原因が分かりません。資料が検索に出ていないのか、出ているのにAIが読み違えたのかで、直す場所がまったく違うからです。この記事では、そのまま使える2段採点表と、結果から改善先を決める対応表を示します。
この記事の目次
公式ドキュメントも「検索の評価」と「回答の評価」を分けている
LlamaIndexの評価ガイドは、評価を回答の評価(Response Evaluation)と検索の評価(Retrieval Evaluation)に分けています。回答側は、回答が取得した文脈に沿っているか(幻覚がないか)を見る「Faithfulness」の例が示され、検索側は関連文書が結果に入ったかを見る hit rate と、関連文書がどれだけ上位にあるかを見る MRR が例示されています。
Microsoft FoundryのRAG評価ページ(2026年10月28日に閲覧)でも、検索ステップを見る「Process evaluation」と、最終回答を見る「System evaluation」に分けて評価器が整理されています。検索側には、取得した文脈が質問に関連するかを見る Retrieval と、正解ラベルと比べる Document Retrieval があります。回答側には Groundedness(文脈に沿っているか)、Relevance(質問に答えているか)、Response Completeness(正解と比べて漏れがないか)があります。同ページでは Response Completeness は preview と表記されていました。
ここから先の採点表は、この「2段に分ける」考え方を、ツールがなくても紙やスプレッドシートで回せるようにした編集上の設計です。公式の評価器そのものの仕様ではありません。
準備:質問ごとに「正解の根拠」を人が決めておく
採点の前に、質問20〜30件ほどを用意し、それぞれに正解の根拠(資料名と該当箇所)を書きます。件数は目安で、まず小さく始めて構いません。
- 実際に聞かれそうな質問を選ぶ(言い回しは社内の実際の表現に寄せる)
- 資料に答えが「ない」質問も数件混ぜる
- 根拠は「就業規則 第12条 2項」のように、後から見て確認できる粒度で書く
資料に答えがない質問では、検索判定は対象外(—)にし、回答判定で「分からないと言えたか」を見ます。
2段採点表:検索判定と回答判定
第1段:検索判定(AIに渡された上位k件を見る)
AIに実際に渡された上位k件(たとえば5件)を、回答を見る前に確認します。回答を先に見ると、正解っぽい文章に引きずられて検索を甘く採点しがちです。
- ○、基準:上位k件の中に、正解の根拠箇所がそのまま入っている
- △、基準:正しい資料は入っているが、根拠箇所が欠けている(文章の途中で切れている、古い版が上位にあるなど)
- ×、基準:正しい資料がk件の中に入っていない
質問全体では「○の割合」を出します。これは LlamaIndex の hit rate と同じ発想の簡易版です。順位まで見たい場合は、根拠が何番目に出たかを別の列に書き、MRR を計算する形に広げられます。
第2段:回答判定(回答を3つの問いで見る)
- ① 根拠に沿っているか、○の基準:回答の内容が、渡された資料に書いてあることだけでできている
- ② 質問に答えているか、○の基準:聞かれたことに直接答えている
- ③ 必要事項が揃っているか、○の基準:条件、例外、数字など、正解の根拠にある要点が落ちていない
3つとも○なら合格です。①が×なら「根拠外の記述」、②が×なら「的外れ」、③が×なら「不足」と型を記録します。
記入シート(説明用の例)
次の表は説明のために作った架空の例で、実際に測定した結果ではありません。
- Q1、質問:出張の宿泊費の上限は?、検索:○、①:○、②:○、③:○、型:合格
- Q2、質問:育休中の社会保険料は?、検索:○、①:×、②:○、③:○、型:根拠外
- Q3、質問:経費精算の締め日は?、検索:△、①:○、②:○、③:×、型:不足
- Q4、質問:在宅勤務の申請先は?、検索:×、①:×、②:○、③:—、型:検索外れ
- Q5、質問:社内の副業可否は?(資料に記載なし)、検索:—、①:○、②:○、③:—、型:「分からない」と言えた
Q4は、答え自体は人が見れば筋が通っていても、検索が外れているので①が×です。これは「たまたま当たった」か、AIの一般知識で答えた可能性があります。資料に沿った答えを求める仕組みでは、不合格として扱うのが安全です。
結果から改善先を決める対応表
検索判定と回答判定の組み合わせで、最初に疑う場所を決めます。
- ○、回答:○、最初に疑う場所:問題なし、最初に試すこと:回答に根拠外の追記がないか抜き取りで確認
- ○、回答:① ×、最初に疑う場所:回答の指示、最初に試すこと:「渡された資料にあることだけで答える」「ないときは分からないと答える」を明記する
- ○、回答:② ×、最初に疑う場所:質問の解釈・指示、最初に試すこと:質問の言い換え方、出力形式の指定を見直す
- ○、回答:③ ×、最初に疑う場所:回答の指示・資料の長さ、最初に試すこと:「条件と例外も書く」と指定する。資料が長すぎないか確認
- △、回答:不足が出る、最初に疑う場所:資料の分割(チャンク)、最初に試すこと:根拠箇所が途中で切れていないか確認し、分割の区切りや前後の重なりを見直す
- ×、回答:×、最初に疑う場所:検索、最初に試すこと:下の「検索が外れたときの切り分け」へ
- ×、回答:○(偶然)、最初に疑う場所:検索(隠れた不具合)、最初に試すこと:合格にせず、検索外れとして扱う
- —(資料なし)、回答:答えてしまった、最初に疑う場所:回答の指示、最初に試すこと:資料にない場合の返答を指示する
検索が外れたときの切り分け
検索が×の質問だけを集め、1件ずつ次の順で確認します。
- 正解の資料は、そもそも検索対象に入っているか(取り込み漏れ、権限の絞り込みで除外されていないか)
- 質問の言葉と資料の言葉が違っていないか(略称、旧名称、言い回しの差)
- 根拠箇所が分割で他の文脈から切り離されていないか
- 渡す件数kが少なすぎないか
1から順に確認すると、設定をいじる前に「資料側の問題」を除外できます。Microsoftのページには、検索パラメータを変えて検索の質を比べる「parameter sweep」の考え方も紹介されています。分割の大きさや件数を変えるときは、1回に1つだけ変えて、同じ質問セットで検索判定を取り直すと効果が比べられます。
AIに採点させる場合の依頼文
人手の採点が負担なら、回答判定の①〜③をAIに下書きさせる方法があります。ただし、AIの採点を鵜呑みにせず、不合格と判定された質問と、合格のうち数件は人が見てください。検索判定は、正解の根拠箇所を人が持っているため、人手のままのほうが確実です。
次の依頼文は未実行の雛形です。機密資料は、説明用のダミーに置き換えてから使ってください。
あなたはRAGの回答を採点します。次の4つが渡されます。
【質問】【正解の根拠】【AIに渡された資料】【AIの回答】

次の3項目を○か×で判定し、×の場合は回答中の該当文を引用して理由を1文で書いてください。
① 回答は【AIに渡された資料】に書いてあることだけでできているか
② 回答は【質問】に直接答えているか
③ 【正解の根拠】の条件・例外・数字が落ちていないか
資料に答えがない質問では、「分からない」と答えていれば①②③とも○とします。
出力は表形式にしてください。
Microsoft Foundryの評価器も、Groundedness は回答と文脈、Response Completeness は正解と回答を入力に使うと説明されています。つまり、何と何を突き合わせて見るかを分ける、という考え方は共通しています。
運用のコツ
- 改善のたびに同じ質問セットで採点し直し、「検索の○の割合」と「回答の合格数」の2つを並べて記録する
- 回答の合格数だけが上がって検索の○が変わっていないなら、改善は指示の側で効いています
- 質問セットは、実際に失敗した質問を足して育てる。ただし、改善に使った質問だけで評価すると甘くなるので、数件は調整に使わない質問として取り分けておく
まずは10問で、上の記入シートを埋めてみてください。×の付いた場所が検索側に偏っているか、回答側に偏っているかが分かれば、最初の改善先が決まります。