社内RAGは小さく始める:対象資料・利用者・期間を絞った試験運用の計画
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
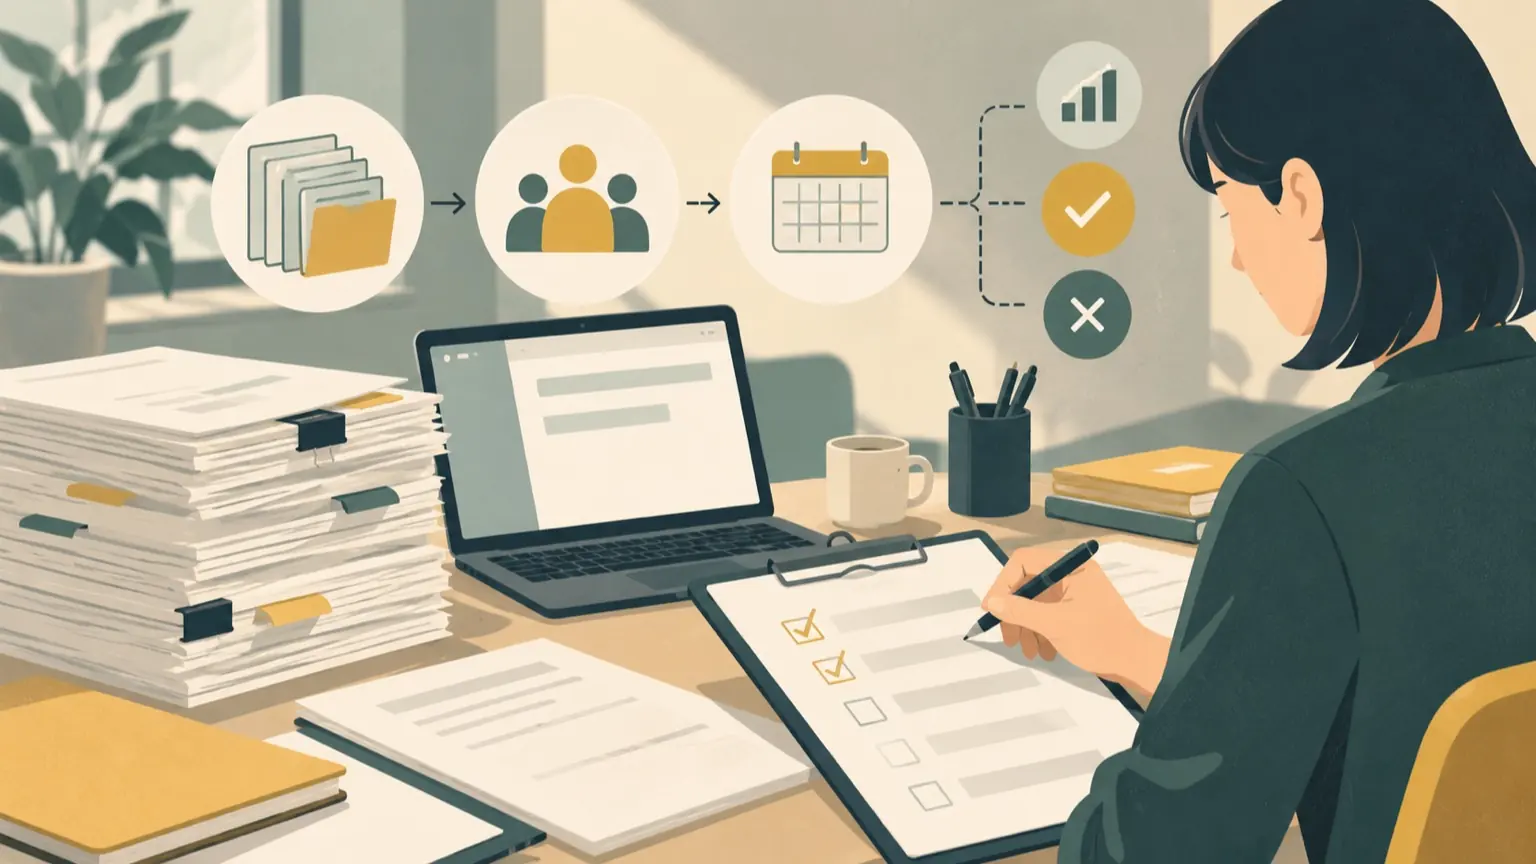
社内RAG(社内資料を検索して、その内容をもとにAIが答える仕組み)は、1つの部署、1種類の資料群、4週間に絞って試すのが安全です。そして開始前に「どうなったら拡大し、継続し、中止するか」を文章で決めておきます。全社展開を前提にすると、資料の整理や権限設計が終わらないまま「なんとなく便利そう」で評価がぼやけます。範囲を絞れば、答えの正確さと運用負荷を実際の数字で見て、次を判断できます。 この記事では、4週間の計画例、評価用の質問セットの作り方、AIに任せる作業の依頼文、判断基準の書き方を順に示します。数値やサンプルはすべて説明用の例で、実際に試験運用して得た結果ではありません。自社の事情に合わせて置き換えてください。
最初に決める3つの絞り込み
絞る軸は「対象資料」「利用者」「期間」です。MicrosoftのRAGソリューション設計ガイド(準備フェーズ)も、最初に業務上の要件を明確にし、どんな質問に答え、どの資料が根拠になるかを決めるよう説明しています。次の表を埋めるところから始めます。
- 解決したい業務、決めること:どの質問に答えさせるか、説明用の例:情報システム部門への「申請方法」問い合わせ
- 対象資料、決めること:種類・形式・件数・更新者、説明用の例:社内ヘルプ手順書(PDFとWord)40件
- 除外資料、決めること:入れないもの、説明用の例:人事評価、顧客の個人情報、契約書原本
- 利用者、決めること:部署・人数・権限、説明用の例:総務と情報システムの8人
- 期間、決めること:開始日・終了日・判断会議の日、説明用の例:4週間、最終週の金曜に判断会議
- 責任者、決めること:資料の正誤を確認する人、説明用の例:各手順書の担当者
対象資料を選ぶときのコツは3つです。
- 更新頻度が低く、正解を人が確認できる資料を選ぶ
- 形式や種類のばらつきを残す(同ガイドは、種類や形式ごとに少なくとも2点の資料を用意するよう勧めています)
- 閲覧権限が分かれる資料は、権限を検索結果にも引き継げるか分かるまで入れない
最後の点は同ガイドも、利用者ごとに見られる内容が違う場合は、分割(チャンク化)後も権限を保つ方法を理解しておくよう述べています。試験運用では、権限が複雑な資料を最初から除外するのが現実的です。
4週間の計画例(説明用)
- 第0週(準備)、目的:範囲と基準の確定、主な作業:上の表を埋める。判断基準(後述)を関係者で合意、週末の成果物:計画書、基準表
- 第1週、目的:土台の確認、主な作業:資料を投入し、評価用質問を作る。担当者だけで動作確認、週末の成果物:質問セット30問、初回の採点
- 第2週、目的:改善、主な作業:誤答の原因を「資料にない/検索で拾えない/回答が資料から外れる」に分類して直す、週末の成果物:原因別の集計、修正内容の記録
- 第3週、目的:実利用、主な作業:8人が日常業務で使う。誤答・不満をその場で記録、週末の成果物:利用ログ、フィードバック一覧
- 第4週、目的:再評価と判断、主な作業:同じ質問セットで再採点。工数と問題を集計、週末の成果物:判断会議資料
第2週の原因分類は、Microsoftのエンドツーエンド評価フェーズの考え方を簡略化したものです。同ページは、回答が根拠の範囲に収まっているか(groundedness)、質問の全部に答えているか(completeness)などの指標を挙げ、結果が低い場合は資料・分割方法・プロンプトの順に見直すよう整理しています。本格的な指標計算は最初は不要で、「誤答のどこが悪いか」を手で分類するだけでも改善点が見えます。
また同ページは、言語モデルの応答は毎回同じとは限らないため、単一の目標値ではなく目標の幅で見るよう注意しています。同じ質問を週ごとに採点して幅で眺めるのは、この点に沿った進め方です。
評価用の質問セットを作る
試験運用の中核は、30問程度の質問セットです。各問を「質問・根拠となる資料の該当箇所・正解」の3点組にします。この形式は前述の準備フェーズのガイドにある、質問・文脈・回答の組と同じ発想です。
質問は次の3種類を混ぜます。
- 資料に書いてあり、1か所を読めば答えられる質問(例:10問)
- 複数の資料や段落を合わせないと答えられない質問(例:10問)
- 資料に書いていない質問(例:10問)。正しい挙動は、作り話をせず「見つかりません」と返すことです
3つ目を入れるのは重要です。ガイドも、資料で答えられない質問を集め、答えられないと伝えるか案内先を示す挙動を確認するよう述べています。
質問案をAIに作らせる依頼文
質問の下書きはAIに任せられます。ただし、質問と正解の妥当性は、業務を知る人が必ず確認します。次の依頼文は、公開しても問題のない資料、または社内で利用が認められた環境でだけ使ってください。機密や個人情報は、架空の内容に置き換えます。
あなたは社内ヘルプデスクの評価担当です。
以下の「資料」だけを根拠に、新入社員が実際に尋ねそうな質問を3つ作ってください。

条件:
- 1つ目は資料の1か所で答えられる質問
- 2つ目は資料の2か所以上を合わせて答える質問
- 3つ目は、資料に答えがない質問(正解は「資料に記載なし」)
- 各質問に、正解と、根拠にした資料の該当箇所の文言を添える
- 資料にない情報を補って正解を書かない
- 出力は表形式(質問/種類/正解/根拠箇所)

資料:
(ここに説明用の手順書の本文を貼る)
AIが作った正解は、必ず担当者が資料と突き合わせて直します。質問を実際の問い合わせ履歴から拾えるなら、そちらを優先してください。ガイドも、本物のコンテンツや実際の質問がある場合はそれを使い、個人情報を取り除いて使うよう勧めています。
拡大・継続・中止の判断基準の書き方
基準は、結果を見る前に、指標・しきい値・判断者・日付の4点を書いて合意します。結果を見てから基準を作ると、都合のよい結論に寄りやすくなります。以下のしきい値は説明用の例です。
採点ルール(説明用)
各回答を次のように採点します。
- ○:資料の内容と一致し、根拠の箇所が示されている
- △:一部正しいが、不足または根拠が不明確
- ×:誤り、または資料にない内容を断定している
- 重大:権限のない資料の内容が出た、個人情報が出た、誤った手順で実害のおそれがある
資料にない質問は、「見つかりません」と返せたら○とします。
判断表(説明用)
- 拡大、条件の例:○が80%以上、重大が0件、×のうち原因が分かったものが大半、利用者の過半数が週2回以上使った、次の行動:対象資料か部署を1段階だけ広げて、再び小さな試験にする
- 継続、条件の例:○が60〜80%、重大が0件、改善が見込める原因が特定済み、次の行動:範囲を変えずに2〜4週間延長し、特定した原因を直す
- 中止、条件の例:○が60%未満で第2週から改善なし、または運用工数が想定を超える、次の行動:学んだことを記録して終了。検索の改善や資料整理のみ続けるか判断
- 即時停止、条件の例:重大が1件でも発生、次の行動:利用を止め、原因と再発防止を確認してから再開を判断
書き方のポイントは次のとおりです。
- 「拡大」でも全社に飛ばさず、次の試験範囲を1段階に限定する
- 正答率とは別に、工数(資料の整備、誤答対応、問い合わせ対応に何時間かかったか)の上限を決める
- 重大な問題は割合ではなく件数で止める
- 資料の中に「この指示に従え」といった文が紛れ込む可能性があります。Microsoftのガイドは、検索対象の文書に悪意ある命令を仕込む間接的なプロンプトインジェクションをリスクとして挙げています。試験の対象資料を管理者が把握している範囲に限る理由にもなります
判断会議の記録テンプレート
最終週の会議では、次の項目を1枚にまとめます。
【試験運用の判断記録】
対象資料:          利用者:          期間:
採点結果:○ __% / △ __% / × __% / 重大 __件
資料にない質問で「見つかりません」と返せた割合:__%
原因別の内訳:資料不足 __件/検索の取りこぼし __件/回答の逸脱 __件
工数:資料整備 __時間、誤答対応 __時間
利用状況:週あたり利用者 __人/8人
判断:拡大 ・ 継続 ・ 中止 ・ 即時停止
理由(基準表のどの行に該当したか):
次の行動と担当・期限:
これを毎回同じ形で残しておくと、資料や質問が変わったときに再評価しやすくなります。Microsoftのガイドも、RAGの設計と評価は一度で終わらず、資料や質問の変化に合わせて繰り返すもので、過去の評価記録が後の判断材料になると説明しています。まずは準備の表と基準表を、今週中に関係者と埋めてみてください。