RAGの評価問題の作り方:社内資料から30問の質問と正解の根拠を用意する
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
結論から言うと、30問は次の流れで作れます。①実際に社内で出た質問を50〜60件集めます。②重複と個人情報を整理して30問に絞ります。③各問に「期待する答え」と「根拠箇所(文書名・版・章や頁)」を、資料を開いて人が書き込みます。④難易度と質問タイプを付けます。正解の文章だけでなく根拠箇所まで残しておくと、間違えたときに「検索で資料を拾えなかったのか」「拾ったのに答え方を誤ったのか」を切り分けられます。 この記事では、そのための評価シートの列、質問の集め方、30問の配分、採点の見方を順に示します。例に出てくる規程や数値は、すべて説明用に作った架空のものです。
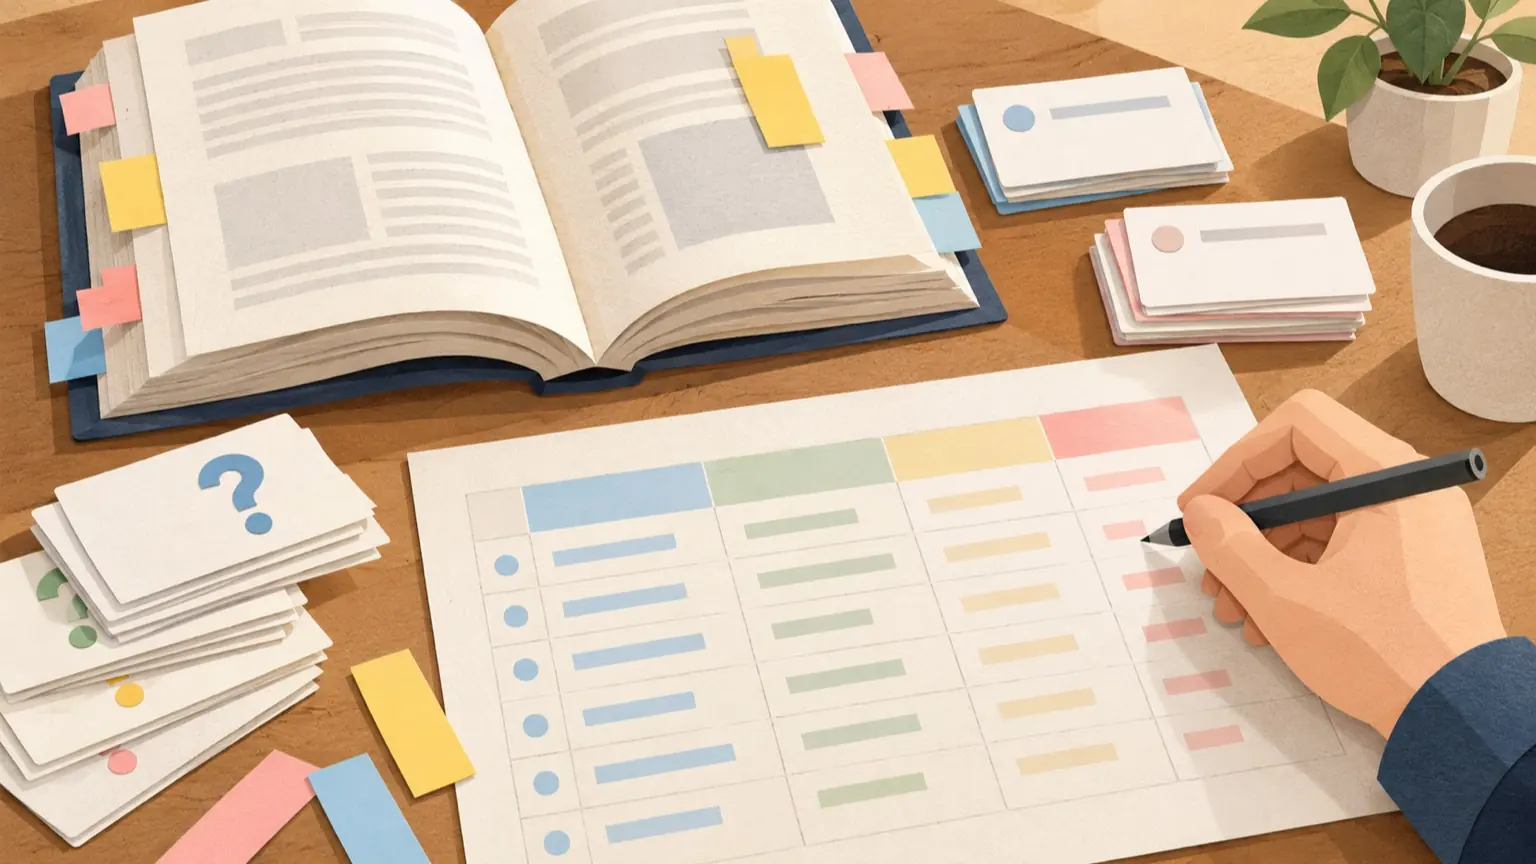
評価シートの列を先に決める
最初に表の形を決めます。表計算ソフトで足ります。
- ID、入れる内容:Q01〜Q30
- 質問、入れる内容:利用者が実際に打つ言い方のまま
- タイプ、入れる内容:事実確認/条件・例外/複数箇所/言い換え/資料にない/版の違い
- 期待する答え、入れる内容:1〜2文。数値や条件は省略しない
- 根拠文書、入れる内容:ファイル名と版・日付
- 根拠箇所、入れる内容:章番号・頁・見出しと、決め手になる語句
- 難易度、入れる内容:易/中/難
- 質問の出所、入れる内容:問い合わせログ、チャット、ヒアリングなど(個人名は書かない)
- 検索結果に根拠が入ったか、入れる内容:○/×
- 回答の判定、入れる内容:○/△/×
下の2列は、評価を回すたびに埋める列です。
記入例(説明用の例)
- Q01、質問:出張の宿泊費の上限っていくら?、タイプ:事実確認、期待する答え:例:1泊1万2千円まで(架空)、根拠箇所:旅費規程_v3 第5条2項、難易度:易
- Q07、質問:前日に急に休む場合、連絡はどこに?、タイプ:言い換え、期待する答え:例:当日始業前に上長へ電話し、後でシステムに入力(架空)、根拠箇所:勤怠ガイド_v2 3.4節、難易度:中
- Q15、質問:海外出張で立替が10万円超のときの承認者は?、タイプ:複数箇所、期待する答え:例:旅費規程の承認表と海外出張の付則の両方を見て部門長(架空)、根拠箇所:旅費規程_v3 別表1、付則2、難易度:難
- Q28、質問:社用スマホの私的利用料金の精算方法は?、タイプ:資料にない、期待する答え:例:資料に記載がないため回答できない旨を述べ、担当窓口を案内する、根拠箇所:(該当なし。検索した語:私的利用、精算)、難易度:中
「資料にない」質問では、根拠箇所の代わりに「どの語で探して見つからなかったか」を残します。後で資料が追加されたとき、答えが変わる質問だと気づけます。
質問の集め方:資料からではなく現場から
手順は次のとおりです。
- 出所を3つ以上決めます。 社内ヘルプデスクの問い合わせ履歴、部署のチャットでの「これどこに書いてある?」、新入社員や異動者への5分ヒアリングなどが候補です。
- 50〜60件を生のまま集めます。 敬語の崩れ、略語、主語の抜けも直しません。実際の利用者が打つ形をそのまま使うのが目的です。
- 機密と個人情報を外します。 氏名、社員番号、取引先名、金額の実数などは架空の値に置き換えます。AIに整理を手伝わせる場合も、外部サービスに渡す前にこの置き換えを済ませてください。
- 重複をまとめ、30問に絞ります。 同じ内容の質問は1問にします。言い方が違う質問は、別の問題として残します。
OpenAIの評価のベストプラクティスは、評価データを実際の利用状況に近づけ、ログから評価例を集めることを勧めています。文書への質問応答の例では、利用者の満足度に関するデータ、専門家が作った正解、過去のログを組み合わせています。また、典型例・エッジケース・敵対的なケースを含め、テストデータに人の専門家によるラベルを付けるよう案内しています。
資料の本文から質問をAIに作らせる方法もありますが、その場合は資料の言い回しをなぞった質問になりがちです。これは私の編集上の見立てで、検証した結果ではありません。実際の質問を土台にして、足りない型だけをAIで補うほうが安全です。
整理用の依頼文の例
質問を整理するときは、次のように「並べ替えと分類だけ」を頼みます。答えを作らせません。
以下は社内で実際に出た質問の一覧です(個人情報は置き換え済み)。
次の作業だけを行ってください。答えは書かないでください。
1. 意味が重複する質問をグループにまとめる
2. 各質問を「事実確認/条件・例外/複数箇所/言い換え/その他」に分類する
3. 言い回しが特殊で、一般の利用者が打たなそうな質問に印を付ける
出力は表(元の番号、グループ、タイプ、印)にしてください。

【質問一覧】
1. …
30問の配分
全部が易しい質問だと、評価が良くても安心できません。次の配分を出発点にします。件数は私の提案で、固定の基準ではありません。
- 事実確認(1か所に書いてある)、問数:8、ねらい:基本の取りこぼしを見る
- 条件・例外つき、問数:6、ねらい:「ただし」「の場合を除く」を落とさないか
- 複数箇所・複数文書、問数:5、ねらい:複数の資料をまたいで答えられるか
- 言い換え・口語、問数:5、ねらい:資料の語と違う言葉で聞かれても拾えるか
- 資料にない、問数:4、ねらい:作り話をせず「分からない」と言えるか
- 版の違い・矛盾、問数:2、ねらい:古い版を根拠にしないか
難易度は、根拠が1か所で語句も一致するなら「易」、言い換えや条件の読み取りが要るなら「中」、複数箇所の突き合わせが要るなら「難」とします。
期待する答えと根拠箇所を書くときの決まり
- 期待する答えは、採点者が○△×を迷わず付けられる形にします。 「規程に従う」ではなく、「1泊1万2千円まで」のように、条件と数値を入れます。
- 根拠は資料を実際に開いて書きます。 記憶や、AIが出した引用をそのまま写さないでください。版・日付も一緒に書くと、規程が改定されたときに、どの問題を見直すかが分かります。
- 根拠が複数あるときは全部書きます。 一部だけ拾えた回答を、あとで「部分的に正しい」と判断できます。
- 担当者が答えを決められない質問は、評価セットに入れません。 現場の担当者や資料の管理者に確認し、確認できるまで保留にします。
採点:検索と回答を別々に見る
AIが出した答えは、期待する答えと根拠箇所を並べて、人が確認します。最初の数十問なら手作業で十分です。
- 検索結果(AIに渡された資料の断片)に根拠箇所が入っていたかを「検索」列に○×で記録します。
- 回答が期待する答えと合っているか、根拠を示しているかを○△×で記録します。
2列の組み合わせで、次に見る場所が変わります。
- ○、回答:○、疑う場所:問題なし
- ○、回答:×、疑う場所:回答を作る指示文、または根拠の読み違い
- ×、回答:×、疑う場所:資料の分割の仕方、検索設定、そもそも資料に書かれていないか
- ×、回答:○、疑う場所:たまたま正解の可能性。根拠なしで答えていないか確認
MicrosoftのRAG評価フェーズの解説は、回答が資料にどれだけ基づくか(groundedness)と、正しいか(correctness)などを併用して原因を探る考え方を示しています。上の表は、それを手作業で使えるようにした私の簡略版です。
同じ質問でも、言語モデルの回答は毎回変わることがあります。上の解説も、1つの目標値ではなく目標の幅で見ることを勧めています。重要な質問は2〜3回流して、結果を見比べてください。
評価セットは更新する
資料が改定されたり、新しい質問が出たりすると、評価セットも古くなります。Microsoftの上の解説も、評価は一度で終わらず、資料や質問の変化に合わせて繰り返すものだと述べています。運用では次のようにします。
- 資料を改定したら、その資料を根拠にしている問題の「期待する答え」と「版」を見直します。
- 本番で「答えが違う」と指摘された質問は、匿名化して追加します。数を増やしすぎないように、同じ型の問題を入れ替えながら30問前後に保つと管理しやすくなります。
- 評価の実行日、使った設定、結果を同じ表に残します。
最初の1回は、完璧な30問より、根拠まで書いた20問のほうが役に立ちます。まず質問の出所を3つ決めて、集めるところから始めてください。