ローカルAIの答えが毎回変わる理由:温度・シード設定と再現性の考え方
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
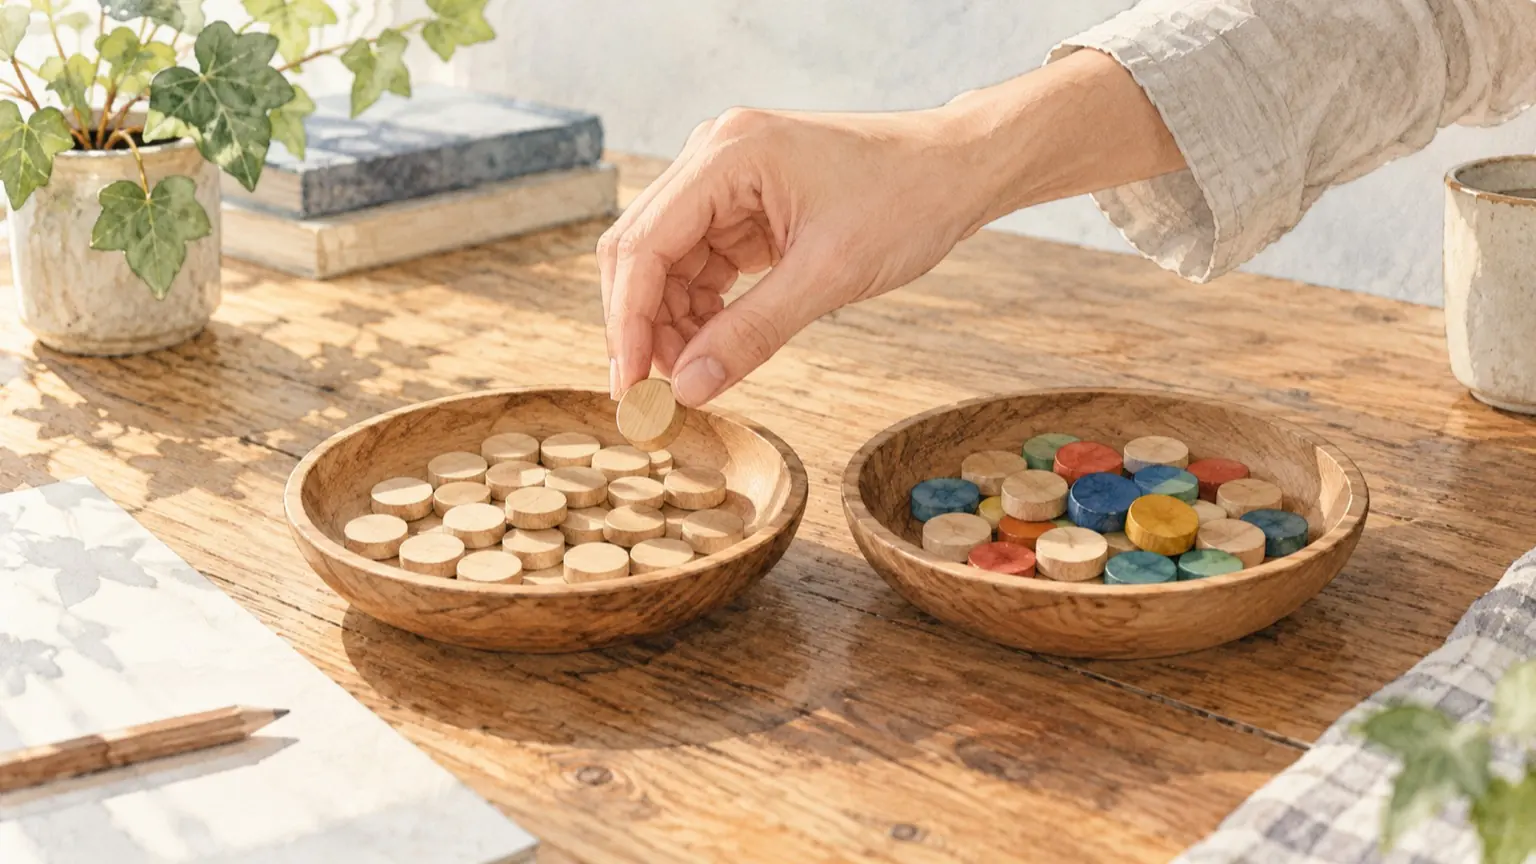
同じ質問を投げたのに、ローカルAIの答えが毎回違う。これは故障ではなく、多くの場合は仕様どおりの動きです。言語モデルは次のトークン(単語やその一部などの単位)の候補に確率をつけ、サンプリングする設定では、その中から「くじ引き」で1つ選んで文章を作ります。くじの偏り具合が温度、くじの乱数の出発点がシードです。 結論から言うと、ばらつきを抑えたい用途(要約の定型化、データ抽出、テスト)では温度を下げてシードを固定し、ばらつきを活かしたい用途(アイデア出し、文体案)では温度を上げてシードは固定しません。ただし、設定を揃えても「必ず完全に同じ」になるとは限りません。この記事では、用途別の決め方の表と、自分の環境で再現できるかを確かめる手順を示します。
答えが変わる原因は3層に分けて考える
「毎回違う」原因は、次の3つに切り分けると調べやすくなります。
- サンプリング設定:温度、top_p、top_kなど。ここが緩いと、同じ入力でも選ばれる単語が変わります。
- 乱数のシード:シード未指定時に毎回別の乱数を使うか、既定の値を使うかは道具や設定によります。固定すれば、同じ条件で同じ乱数列を使えます。
- 入力や環境の違い:プロンプトの空白1文字、会話履歴の長さ、モデルのバージョン、ソフトやハードの違いでも結果は動きます。
OllamaのModelfileのパラメータ説明では、temperatureは「上げるほど創造的に答える」、seedは「特定の数値にすると同じプロンプトに対して同じテキストを生成するようになる」、top_pとtop_kは小さくするほど保守的、大きくするほど多様になる、と説明されています。同ページに載っている既定値は、temperatureが0.8、top_pが0.9、top_kが40です(2026年10月29日の公開ページで確認。将来変わる可能性があります)。ただし、モデル側の設定などで上書きされる場合があるため、この値がすべてのモデルでそのまま使われるとは限りません。
用途別・温度設定の考え方表
次の数値は公式の推奨値ではなく、編集部が考えた出発点の目安です。モデルによって適した値は違うため、後述の手順で自分のモデルを試して調整してください。
- 項目抽出・分類・JSON整形、温度の目安:0〜0.2、シード:固定、考え方:毎回同じ形式で返ってほしい。ばらつきは不具合になる
- 要約・翻訳の下書き、温度の目安:0.2〜0.5、シード:固定または未指定、考え方:内容は安定させたいが、言い回しの揺れは許せる
- 質問応答・コード補助、温度の目安:0.3〜0.7、シード:未指定、考え方:回答の揺れを見ながら調整する。正確さは温度だけでは保証できず、誤りは人が確認する
- 文章の推敲案・タイトル案、温度の目安:0.7〜1.0、シード:未指定、考え方:複数案を比べるのが目的。毎回違って構わない
- ブレインストーミング・物語、温度の目安:1.0前後、シード:未指定、考え方:意外性が価値。ただし破綻も増えるので取捨選択する
判断の軸は「出力を機械が受け取るか、人が読むか」です。後続のプログラムが読む出力は、ばらつきが即エラーにつながるので抑えます。人が選ぶ出力は、複数回生成して良いものを採る使い方ができるので、ばらつきが武器になります。温度を下げてもJSONの構文や項目の正しさは保証されません。機械が読む場合は、Ollama APIのformat指定でJSONやJSON Schemaを使い、受け取った結果も検証してください。
温度を極端に下げると、同じ言い回しの繰り返しに陥ることもあります。そのときは温度を少し戻すか、Modelfileに載っている繰り返し抑制の設定(repeat_penalty)を検討してください。
同じ出力を再現できるか確かめる手順
ここでは、Ollamaを起動した状態でAPIに同じ依頼を5回送り、出力が一致するかを確かめます。OllamaのAPIドキュメントでは、リクエストのJSONにoptionsを入れてtemperatureやseedを渡し、"stream": falseで完全な応答を1つのJSONとして受け取れる、と示されています。
下のスクリプトは説明用の例で、この原稿の作成時点では実行していません。Bash、curl、jq、shasumが必要です。モデル名、アドレス(公式例ではlocalhostの11434番ポートですが、お使いの設定に読み替えてください)は環境に合わせて直してください。
#!/bin/bash
set -euo pipefail
MODEL="使うモデル名"
URL="http://localhost:11434/api/generate"
PROMPT="日本の四季を、各季節15字以内で説明してください。"

run() {  # 引数: 温度 シード
  for i in 1 2 3 4 5; do
    curl -fsS "$URL" -d "{
      \"model\": \"$MODEL\",
      \"prompt\": \"$PROMPT\",
      \"stream\": false,
      \"options\": {\"temperature\": $1, \"seed\": $2}
    }" | jq -ej 'if .done == true and (.response | type == "string" and length > 0) then .response else error("応答が未完了・空、またはAPIエラーです") end' | shasum -a 256
  done | sort | uniq -c
}

echo "A: 温度0.8 / シード42"; run 0.8 42
echo "B: 温度0 / シード42";   run 0 42
出力はresponse本文の「ハッシュ値ごとの件数」です。5回すべて同じなら、行は1本で件数が5になります。通信失敗、APIエラー、未完了・空の応答では処理を止めます。エラーや件数が5に満たない結果は、一致の判定に使わないでください。思考過程を別のthinking欄に返すモデルでも、この例ではその欄を比較しません。
結果の読み方
- Aで1行(5件):温度0.8・シード42で、今回の入力と環境では5回の回答本文が一致したと判断できます。将来の実行や別の入力での一致までは保証しません。
- Aで複数行:シードだけでは一致していません。送信した入力・設定、モデル、実行ソフトの版や計算環境が揃っているかを確認します。
- Bで1行(5件):今回の入力と環境では低温度でも一致しています。再現が必要な処理の設定候補として、実際に使う入力でも確認してください。
- Bで複数行:温度0でも揺れる環境です。完全一致を前提にした設計は避け、出力を検証する工程を挟みましょう。
この確認は「同じPC・同じモデル・同じソフトのバージョン」での結果です。別のPCへ移したり、ソフトを更新したりしたあとは、同じ手順をもう一度流して結果を確かめ直してください。
設定を揃えても完全一致を約束できない理由
PyTorchの再現性に関するドキュメントには、完全に再現可能な結果はリリース間、個別のコミット間、異なるプラットフォーム間では保証されず、CPUとGPUの間でも結果が違いうると書かれています。乱数シードを固定しても、他の非決定的な要因を排除する必要があり、決定的なアルゴリズムを強制すると速度が落ちる場合があるとも説明されています。
Ollamaのような実行ソフトがPyTorchを使っているとは限らず、この資料がOllamaの再現性を直接保証するわけではありません。PyTorchの数値精度の説明では、浮動小数点演算は計算順序によって結果が変わるとされています。こうした数値の差が候補の選択に影響しうることも、環境を変えたら再確認する理由の一つです。実務では次のように割り切るのが安全です。
- 同じ環境内の再現:シード固定と低温度を出発点に、実際の入力で一致するか確認する
- 環境をまたぐ再現:期待しない。結果を保存しておく
- 検証が必要な用途:生成結果そのものをファイルに残し、再生成では代用しない
実際の運用に落とすときのチェックリスト
- 用途を「機械が読む」か「人が選ぶ」かに分ける
- 表の温度から始め、同じ依頼を5〜10回流して、ばらつきが許容範囲か確かめる
- 再現が必要なものはシードを固定し、モデル名・バージョン・設定値を記録する
- ソフトやモデルを更新したら、再現確認の手順を流し直す
- 一致が必須の場合は、生成結果を保存する
記録には、モデル名と実体を識別できるID、量子化の種類、実行ソフトの版、CPU・GPU、温度、top_p、top_k、シード、その他の生成設定、システム指示や会話履歴を含む入力全文を残してください。どれか1つが欠けると、後から同じ条件を作れなくなります。
LM Studioなど画面で操作する道具でも、温度やシードに当たる設定欄があるかを確認し、同じ考え方で値を決められます。設定欄の名前や場所はアプリの版によって変わるため、ここでは画面操作の手順までは扱いません。