プロンプトキャッシュはどこで効く?OpenAI・Claude・Geminiの仕組みと設計の違い
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
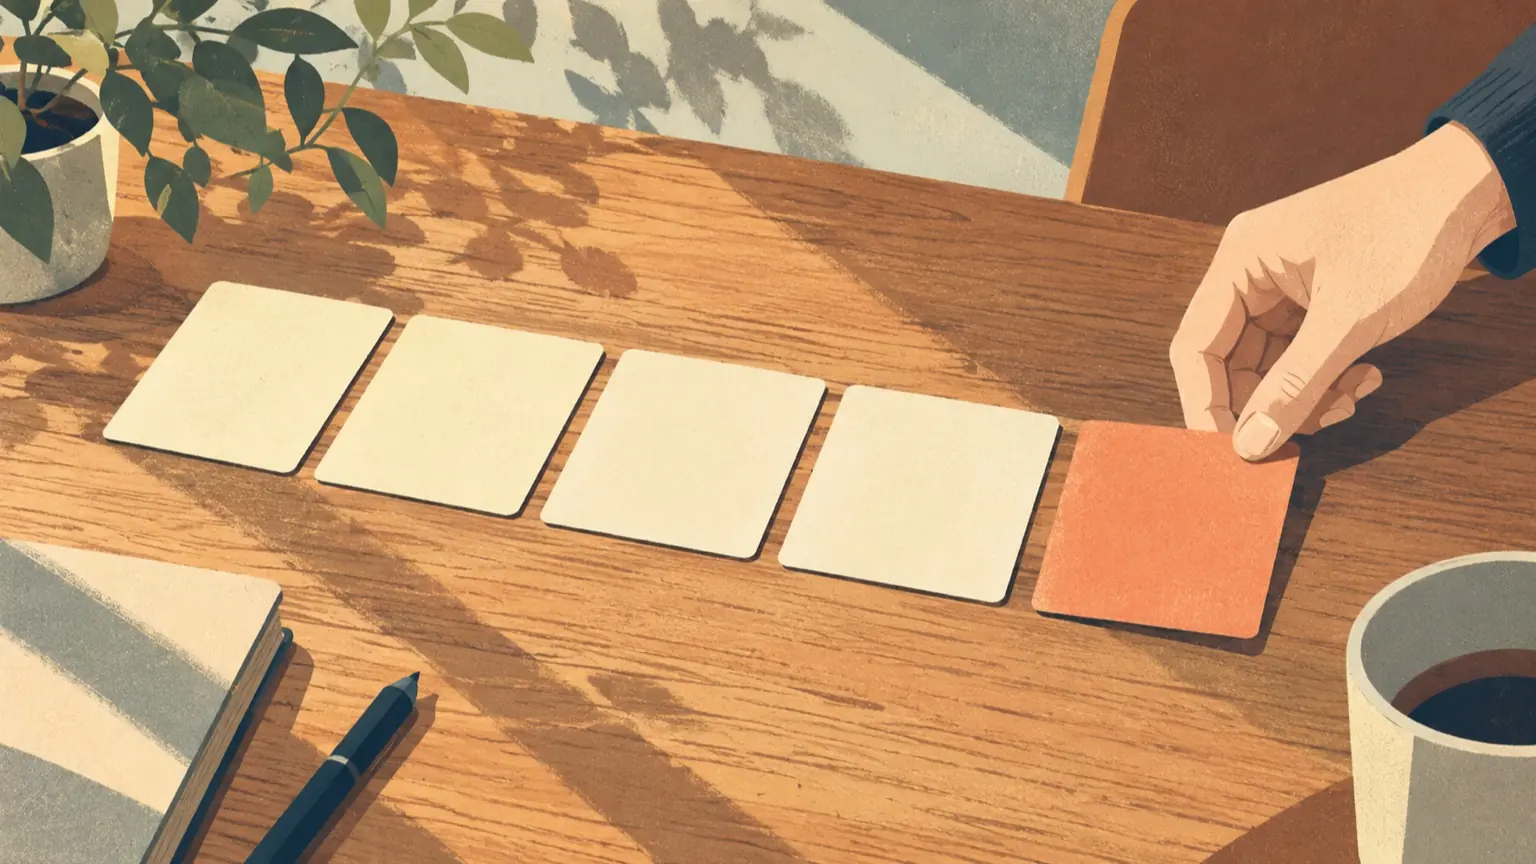
プロンプトキャッシュが効くのは、リクエストの先頭から連続して、前回と完全に一致している部分です。途中に毎回変わる文字列が入ると、そこから後ろは同じプレフィックスとして再利用できません。ただし、先頭が一致するだけでヒットするとは限らず、各社の最小トークン数、キャッシュの保存位置や保持条件も満たす必要があります。 だから設計の基本は「変わらないものを前、変わるものを後ろ」に並べることです。違いが出るのは、有効化の方法、保持時間、キャッシュ対象になる最小トークン数、料金の扱いです。この記事では、並べ替えの具体例と3社の条件比較表を示します。 確認した資料は、OpenAIのPrompt Cachingガイド、ClaudeのPrompt cachingドキュメント、GeminiのContext cachingです。いずれも2026年10月29日の自動校閲で本文を確認しました。モデル名や数値は更新が早いため、実装前に各ページで再確認してください。
キャッシュが効く条件は「先頭からの完全一致」
OpenAIのガイドは、キャッシュの再利用にはレンダリング後のプレフィックス全体の一致が必要だと説明しています。変更点より前の部分は残りますが、変更点より後ろは既存のキャッシュと一致しません。
Claudeはこの順序が明示されています。プレフィックスは「ツール定義 → system → messages」の順に作られ、上の階層が変わると下の階層も無効になります。ツール定義を変えると全体が無効になる、という扱いです。
Geminiも、共通する大きな内容をプロンプトの先頭に置き、似たリクエストを短い間隔で送るよう案内しています。
つまり、次のものが先頭付近に入っていると、キャッシュを壊しやすくなります。
- 現在時刻やリクエストIDなど、毎回変わる値
- ユーザーごとの名前や設定
- 動的に生成したツール定義や、順序が毎回変わるJSON
並べ替え例:Before と After
以下は説明用の例です。実際にAPIへ送って測定したものではありません。社内FAQボットを想定しています。
Before(キャッシュが効きにくい)
[system]
現在時刻: 2026-10-27 14:03:22
ユーザー: 田中さん(プラン: Pro)
あなたは社内FAQアシスタントです。回答ルールは次のとおりです……(約3,000トークン)

[user]
有給の申請方法は?
先頭に近い「現在時刻」が毎回変わるため、後ろの3,000トークンの規程も毎回別のプレフィックスとして扱われます。
After(固定部分を前に集約)
[tools]   ツール定義(順序・内容とも固定)
[system]  回答ルール・口調・出力形式(固定)
[system]  FAQ本文・規程(固定。更新時のみ変わる)
[user]    現在時刻: 2026-10-27 14:03:22
          ユーザー: 田中さん(プラン: Pro)
          質問: 有給の申請方法は?
この例では、変わる情報を末尾のユーザーメッセージに寄せています。ただし、指示の権限が変わらないよう、開発者からの指示とユーザー入力は各APIの役割に従って分けてください。Claudeでは固定部分の最後のブロックに cache_control を置きます。末尾の質問が毎回変わる独立したリクエストでは、最上位の自動指定だけでは固定部分を再利用できない場合があります。OpenAIのGPT-5.6以降でも、固定部分の末尾への明示ブレークポイントを検討します。会話が続く場合は、過去のやり取りを書き換えず、追記だけにします。古い発話の要約や削除を挟むと、その位置から先は一致しなくなります。
並べ替えを依頼するときのAI向け入力例
既存のプロンプトを見直すときは、次のように依頼できます。機密情報は伏せ字やダミーに置き換えて渡してください。
次のプロンプト構成を、プロンプトキャッシュが効きやすい順に並べ替えてください。
条件:
- 毎回変わる要素と、ほぼ変わらない要素に分類する
- 固定要素を先頭、変動要素を末尾にする
- 意味や指示内容は変えない
- 分類の根拠を表で示す
【現在の構成】(ダミー化したプロンプトを貼る)
出力された構成は、そのまま採用せず、開発者が指示の意味が変わっていないか確認してください。
3社の条件比較表
下の表は、前述の3つの資料に書かれていた内容に基づきます。モデルごとに異なる項目は、確認できた範囲だけを載せています。
- 有効化、OpenAI:対応モデルでは既定で有効、Claude:リクエスト最上位に cache_control を置く自動方式か、ブロックごとの明示指定、Gemini:Gemini 2.5以降で暗黙キャッシュが既定で有効
- 明示的な指定、OpenAI:GPT-5.6以降は prompt_cache_options.mode と prompt_cache_breakpoint で明示指定も可能。prompt_cache_key は別途、集計分離や旧モデルのルーティングに使用、Claude:ブレークポイントは1リクエストにつき最大4つ、Gemini:明示キャッシュは別方式。Interactions APIとGemini 4 Argon以降では非対応と記載
- 最小トークン数、OpenAI:GPT-5.6以降は1,024。旧モデルは設定により異なる、Claude:モデルにより512〜4,096、Gemini:確認したモデルでは2,048または4,096
- 保持時間、OpenAI:GPT-5.6以降のResponses APIは prompt_cache_options.ttl で最低30分(既定)か12時間。旧モデルはモデルに応じて prompt_cache_retention の in_memory/24h(GPT-5.5/Proは 24h のみ)、Claude:5分(既定、利用のたびに延長)か、ttl: "1h" の1時間、Gemini:暗黙キャッシュの保持時間は確認した範囲では記載なし
- 料金、OpenAI:GPT-5.6以降の読み取りは通常入力の0.1倍(GPT-6.1 Sol/Terraは0.05倍)。Responses APIの書き込みは30分で1.25倍、12時間で2.5倍。旧モデルの読み取りはモデル別、追加の書き込み料金なし、Claude:5分書き込み1.25倍、1時間書き込み2倍。読み取りは通常0.1倍、Opus 5.5/Sonnet 5.5は0.05倍、Fable 5.1/Mythos 5.1は0.025倍、Gemini:「ヒット時にコスト削減を自動で反映する」との記載。具体的な倍率は確認していない
- ヒットの確認、OpenAI:Responses APIの usage.input_tokens_details.cached_tokens、Claude:usage.cache_read_input_tokens が読み取り、usage.cache_creation_input_tokens が書き込み、Gemini:Interactions APIは usage.total_cached_tokens、generateContentのREST応答は usageMetadata.cachedContentTokenCount
Geminiのフィールドは、generateContentのAPIリファレンスも確認しました。Gemini 4 Argon以降の複数ターンでは、前回リクエスト全体のキャッシュには新たに2,050トークン以上の追加が必要です。追加がそれ未満だと前回末尾の2,050トークンが通常入力料金で再処理されます。モデルの出力、思考、関数の結果も追加量に含まれます。
設計に効く違い
Claudeは「どこまでをキャッシュするか」を自分で指定できます。 ブレークポイントを置いた位置までがキャッシュ対象です。ブロックが20個を超えて伸びる会話では、ドキュメントが遡って探す範囲を20位置と説明しています。長いエージェントでは、途中に2つ目のブレークポイントを置く対策が示されています。
OpenAIとGeminiには、既定で有効な暗黙キャッシュがあります。 ただし、並べ替えだけでヒットするとは限りません。OpenAIのGPT-5.6以降では明示ブレークポイントも指定できます。固定の prompt_cache_key によるルーティング最適化はGPT-5.6より前のモデル向けで、GPT-5.6以降では顧客・ユーザー別のキャッシュ集計を分ける用途に使えます。
保持時間は設計に直結します。 アクセスが少ない夜間の社内ツールなどは、長めの保持と書き込み料金を合わせて検討します。ただし、OpenAIのGPT-5.6以降の30分・12時間はキャッシュ読み取り料金が適用される最低期間で、削除期限やレイテンシ改善の保証ではありません。旧モデルの 24h は最大24時間であり、24時間の再利用を保証しません。Claudeの5分・1時間は利用のたびに更新されます。
効果を確認する手順
キャッシュが効いたかどうかは、レスポンスの使用量フィールドで確認できます。次の流れで試せます。以下は手順の例で、結果は示していません。
- 最小トークン数を満たす固定部分(規程や例文など)を用意する。足りないと、そもそもキャッシュされません。Claudeでは固定部分の末尾に cache_control を置き、OpenAIのGPT-5.6以降でも必要に応じて同じ位置に明示ブレークポイントを置きます。
- 同じ固定部分で、質問だけ変えて2回続けて送る。
- 2回目のレスポンスで、キャッシュ読み取りのトークン数が0より大きいか確認する(上の表の各フィールド)。
- 0のままなら、先頭からの差分を探す。時刻、ID、JSONのキー順、ツール定義の順序が典型的な原因です。差分がなければ、ブレークポイントの位置、保持条件、ルーティングも確認します。
- Claudeでは、ツール定義、Web検索や引用機能の切り替え、画像の追加・削除なども、キャッシュを無効にする要因として挙げられています。
ログには、入力トークンの合計に対するキャッシュ読み取り量の比率を記録しておくと、プロンプト変更の影響を追えます。Claudeでは、合計入力が「読み取り+書き込み+最後のブレークポイント以降の入力」の和になる点に注意が必要です。
どの構成にするかの判断表
- 長いsystemと固定の資料を毎回付ける、優先すること:固定部分を先頭に集約。変動情報は末尾のユーザーメッセージへ
- 利用間隔が数分以上空く、優先すること:保持時間の延長オプションと追加料金の倍率を比較
- 会話が長く、ブロック数が増える(Claude)、優先すること:途中にブレークポイントを追加し、遡り範囲から外れないようにする
- ツールを動的に出し分けている、優先すること:ツール定義の順序と内容を固定する。変えると以降のキャッシュが無効になる
- 最小トークン数に届かない、優先すること:無理に水増しせず、キャッシュ前提の設計をやめる
最小トークン数に届かない短いプロンプトは、キャッシュ以外の最適化を考えるほうが現実的です。固定部分を増やすためだけに文章を足すと、通常の入力料金が増える場合があります。
実装前に確認しておくこと
この記事の数値や名称は、2026年10月29日の自動校閲で本文を確認した公式ドキュメントの記述に基づきます。モデルの追加や仕様変更で変わりうるため、使うモデルの最小トークン数、保持時間、料金は、実装前にそれぞれの公式ページで確認してください。
また、キャッシュは料金とレイテンシの最適化であり、出力の内容を保証するものではありません。キャッシュに載せる資料に個人情報や機密情報を含める場合は、各社のデータ取り扱い規約と自社の方針を別途確認してください。学習への利用設定と、情報の秘密保持は別の問題です。