LLM APIのタイムアウトは段階で決める:接続・最初の出力・全体の待ち時間設計
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
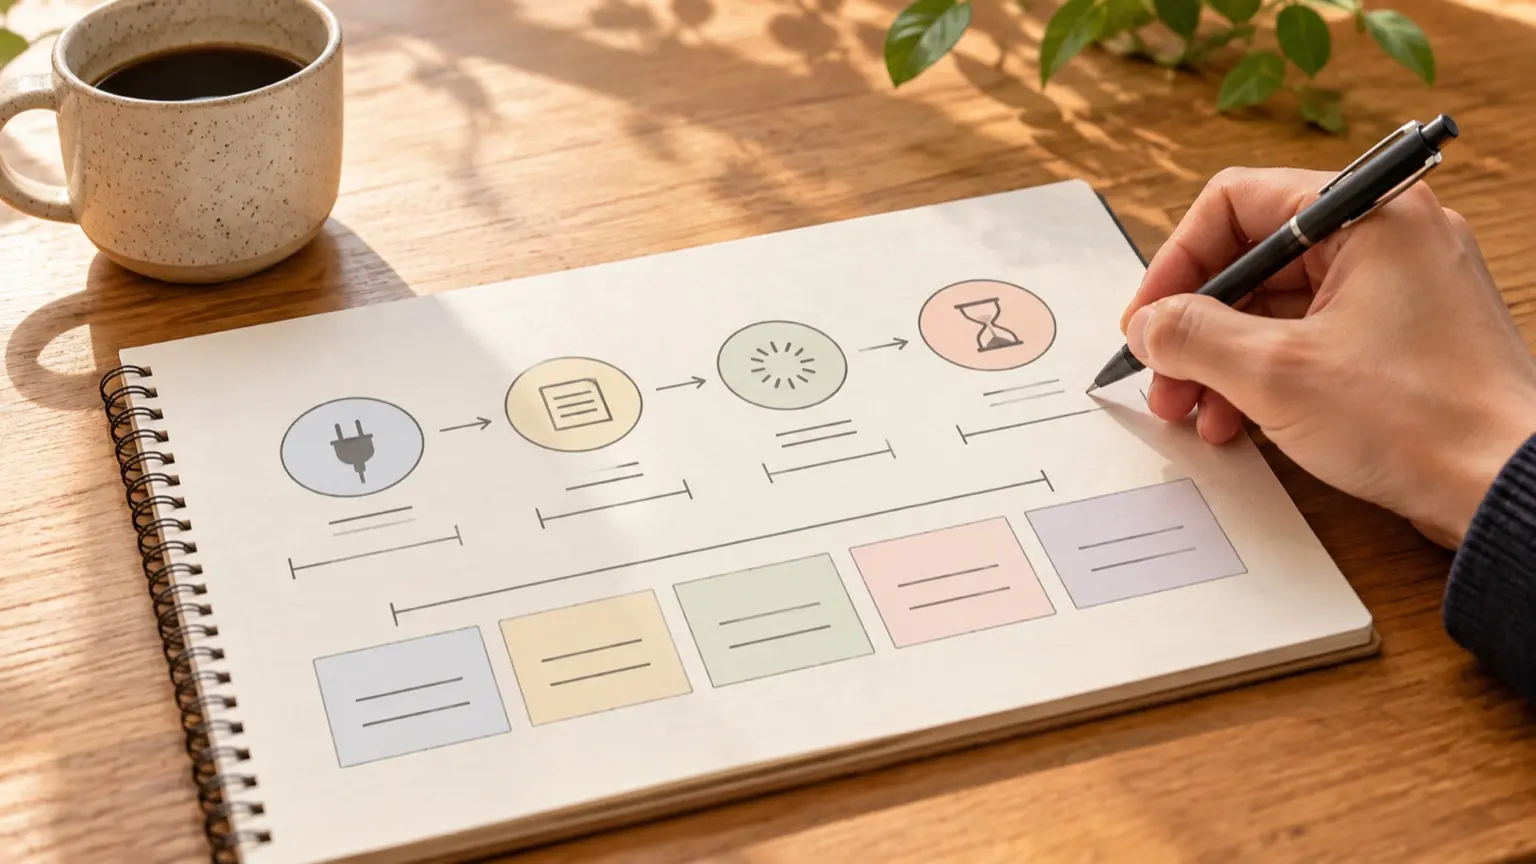
LLM APIのタイムアウトは「30秒」のように1つの値で決めないでください。答えは、接続、最初の出力、出力の途切れ、全体、再試行を含めた総予算の5つに分け、さらに用途ごとに別の値を持たせることです。理由は単純で、短い分類と長文生成では所要時間の桁が違い、失敗の原因も違うからです。1つの値だと、長い処理を誤って切るか、止まった接続をいつまでも待つかのどちらかになります。 この記事の後半に、値を自社の計測で埋める「用途別タイムアウト設計シート」を用意しました。先に考え方を整理し、そのあとで計測と記入の手順に進みます。
この記事の目次
5つの待ち時間は、見ている異常が違う
- ① 接続、検知したい異常:ネットワーク不通、名前解決や接続確立の失敗、備考:モデルの重さとは無関係なので短くできる
- ② 最初の出力、検知したい異常:リクエストは届いたが、応答が始まらない、備考:ストリーミング時のみ「最初のイベント」で測れる
- ③ 出力の途切れ、検知したい異常:出力が始まったあとで止まった、備考:直前のイベントからの無通信時間で見る
- ④ 全体、検知したい異常:長引きすぎ、ユーザー体験や業務の期限超過、備考:上限は用途の要件から逆算する
- ⑤ 再試行を含む総予算、検知したい異常:再試行を重ねて想定以上に待たせる、備考:①〜④とは別に持つ
①〜④は一般的なHTTPクライアントの考え方を整理した編集上の区分です。名称や設定できる範囲はライブラリごとに違うので、お使いのSDKやHTTPクライアントで、どれを個別に指定できるか先に確認してください。
ストリーミングにすると②③が見えるようになる
非ストリーミングでは、応答が全部できるまで何も届きません。待ち時間は「全体」の1本しか観測できず、止まっているのか生成中なのか区別できません。
ストリーミングなら途中経過が届きます。OpenAIのResponses APIでは、response.created、複数回のresponse.output_text.delta、response.completed、errorといった型付きイベントが流れると公式ガイドに書かれています。最初のresponse.output_text.deltaまでの時間を「最初の出力」、delta同士の間隔を「出力の途切れ」として計測できます。
Anthropicも長いリクエストにはストリーミングかBatch APIを検討するよう案内しています。非ストリーミングでmax_tokensを大きくすると、環境によってはアイドル接続が切られ、応答を受け取れないまま失敗や時間切れになりうるためです(Claude APIのエラー説明の「Long requests」、2026年10月27日に確認)。同ページでは、504のtimeout_errorが出たときもストリーミングを検討するよう書かれています。
注意点が2つあります。
- 「最初のイベント」と「最初の見えるテキスト」は同じとは限りません。 推論を行う設定やツール呼び出しを挟む場合、先に別種のイベントが届くことがあります。②は「画面に文字が出るまで」で測るのか、「最初のイベントまで」で測るのかを、シートに明記してください。
- 200が返ったあとにもエラーは起こります。 Claude APIでは、SSEで200を返した後のエラーは通常のHTTPエラー処理とは別扱いで、ストリーム内のエラーイベントとして届くとされています(同上ページ)。OpenAI側にもerrorイベントがあります。HTTPステータスだけを見る実装では拾えません。
再試行を足すと総待ち時間は何倍にもなる
⑤が必要な理由は掛け算です。Claudeの公式SDKは、接続エラー、レート制限、5xxなどの一時的な失敗を指数バックオフで自動再試行し、既定は2回です(Claude APIのエラー説明)。つまり最大3回試行します。1回あたりの全体上限を60秒にしていれば、最悪ケースの待ちはバックオフを除いても約180秒です。
自前の再試行やゲートウェイ側の再試行が重なると、さらに増えます。上限は次の式で逆算してください。
ユーザーが待てる総時間 ≥ (試行回数 × 1回あたりの全体上限) + バックオフ合計SDKの既定の再試行が、時間切れ(タイムアウト)そのものにも働くかどうかは、SDKとバージョンで違う可能性があります。使うSDKのドキュメントか挙動で確認し、シートの「再試行対象」欄に書いてください。
用途別タイムアウト設計シート
次の表をコピーして使います。各欄は自社の計測で埋める欄で、本記事は具体的な秒数を示しません。右の「判断の軸」は、値を決めるときの考え方です。
- チャットUI(ストリーミング)、①接続:_秒、②最初の出力:_秒、③出力の途切れ:_秒、④全体:_秒、試行回数:_回、⑤総予算:_秒、超過時の動作:受信済みの部分を残して再生成ボタンを出す、判断の軸:②と③を厳しめに。④はユーザーが離脱する時間から決める
- 短い分類・タグ付け(非ストリーミング可)、①接続:_秒、②最初の出力:(測れない)、③出力の途切れ:(測れない)、④全体:_秒、試行回数:_回、⑤総予算:_秒、超過時の動作:既定値のラベルか人手キューへ、判断の軸:出力が短いので④を主に管理。再試行は許容しやすい
- 構造化抽出(JSON)、①接続:_秒、②最初の出力:_秒、③出力の途切れ:_秒、④全体:_秒、試行回数:_回、⑤総予算:_秒、超過時の動作:部分JSONは捨てて再試行、判断の軸:途中のJSONは使えないので、切れた場合は全体を無効に
- 長文生成・レポート、①接続:_秒、②最初の出力:_秒、③出力の途切れ:_秒、④全体:_秒、試行回数:_回、⑤総予算:_秒、超過時の動作:非同期ジョブ化し、完了通知で返す、判断の軸:ストリーミングか非同期処理が前提。同期の長待ちを避ける
- ツール呼び出しを含むエージェント、①接続:_秒、②最初の出力:_秒、③出力の途切れ:_秒、④全体:1ステップ_秒 / 全工程_秒、試行回数:_回、⑤総予算:_秒、超過時の動作:工程の途中で打ち切り、状態を保存、判断の軸:1回の呼び出しと全工程の上限を別に持つ
- バッチ・夜間処理、①接続:_秒、②最初の出力:-、③出力の途切れ:-、④全体:_秒、試行回数:_回、⑤総予算:_秒、超過時の動作:失敗分を次回キューへ、判断の軸:即時性は不要。Batch APIも選択肢(Claudeでは提供されています)
追加で埋める共通欄です。
- 記録単位:リクエストID、モデル名、入力トークン数、max_tokens(上限出力)、リージョン。Claude APIの全レスポンスにはrequest-idヘッダーが付き、問い合わせ時に使えます(Claude APIのエラー説明)。
- 再試行対象:接続失敗、429、5xx、時間切れ、ストリーム途中のエラーのうち、どれを再試行するか。
- 途中まで出力した後の扱い:捨てる、残す、人に見せる、のどれか。ストリーミングでは、部分的な出力は内容の確認が難しくなるとOpenAIが注意しています。ユーザーに見せる前に審査が必要なサービスなら、この欄は必須です。
値を埋める計測手順
- 用途ごとに代表的な入力を用意します。 短い、普通、最長の3種類を、実際の入力に近い形で作ってください。機密情報は説明用データに置き換えます。
- 各リクエストで5つの時刻を記録します。 送信開始、接続完了、最初の出力、最後のイベント、完了。ストリーミングなら、イベント間隔の最大値も残します。
- 時間帯を分けて数十〜数百回の件数を集めます。 件数と時間帯の目安は自社の呼び出し量で決めてください。1回の速い結果から値を決めないことが大切です。
- 分布で見ます。 平均ではなくp95やp99を見ます。そこに余裕係数を掛けて初期値にします。係数は仮に1.5倍から始め、誤検知(正常なのに切った件数)が許容を超えたら上げる、という運用が一案です。この係数は編集上の提案で、公式の推奨値ではありません。
- ⑤の式で総予算を検算します。 超えるなら、試行回数か④を下げるか、同期処理をやめて非同期にします。
- 意図的に失敗させて確認します。 値を極端に小さくして、超過時の動作の列どおりに画面や後続処理が動くかを見てください。
計測ログの整理を手伝わせる依頼文(説明用)
集めたログの集計をAIに任せるなら、次のように依頼できます。人が確認するのは、集計の元データと外れ値の扱いです。
以下は、LLM API呼び出しの計測ログ(CSV)です。列は
用途, 入力トークン数, 接続ms, 最初の出力ms, 最大イベント間隔ms, 全体ms, 結果(成功/時間切れ/エラー)です。

用途ごとに、各列のp50・p95・p99と件数を表にしてください。
結果が成功以外の行は別表にまとめ、推測で補わず、元の行番号を付けてください。
件数が少なく判断しにくい用途があれば、そう明記してください。
値の提案はせず、集計だけを返してください。
集計だけを頼み、秒数の決定は人が行います。AIが出した数値は、元データの数件と突き合わせてから採用してください。
運用で見直すタイミング
モデルの変更、max_tokensの変更、プロンプトの大幅な増量、リージョンや接続経路の変更のあとは、②と④が変わりやすくなります。シートに「最終計測日」と「計測時のモデル名」の欄を足し、変更のたびに再計測してください。