コンテキスト長を伸ばすとメモリが増える理由と、長文を扱う設定の考え方
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
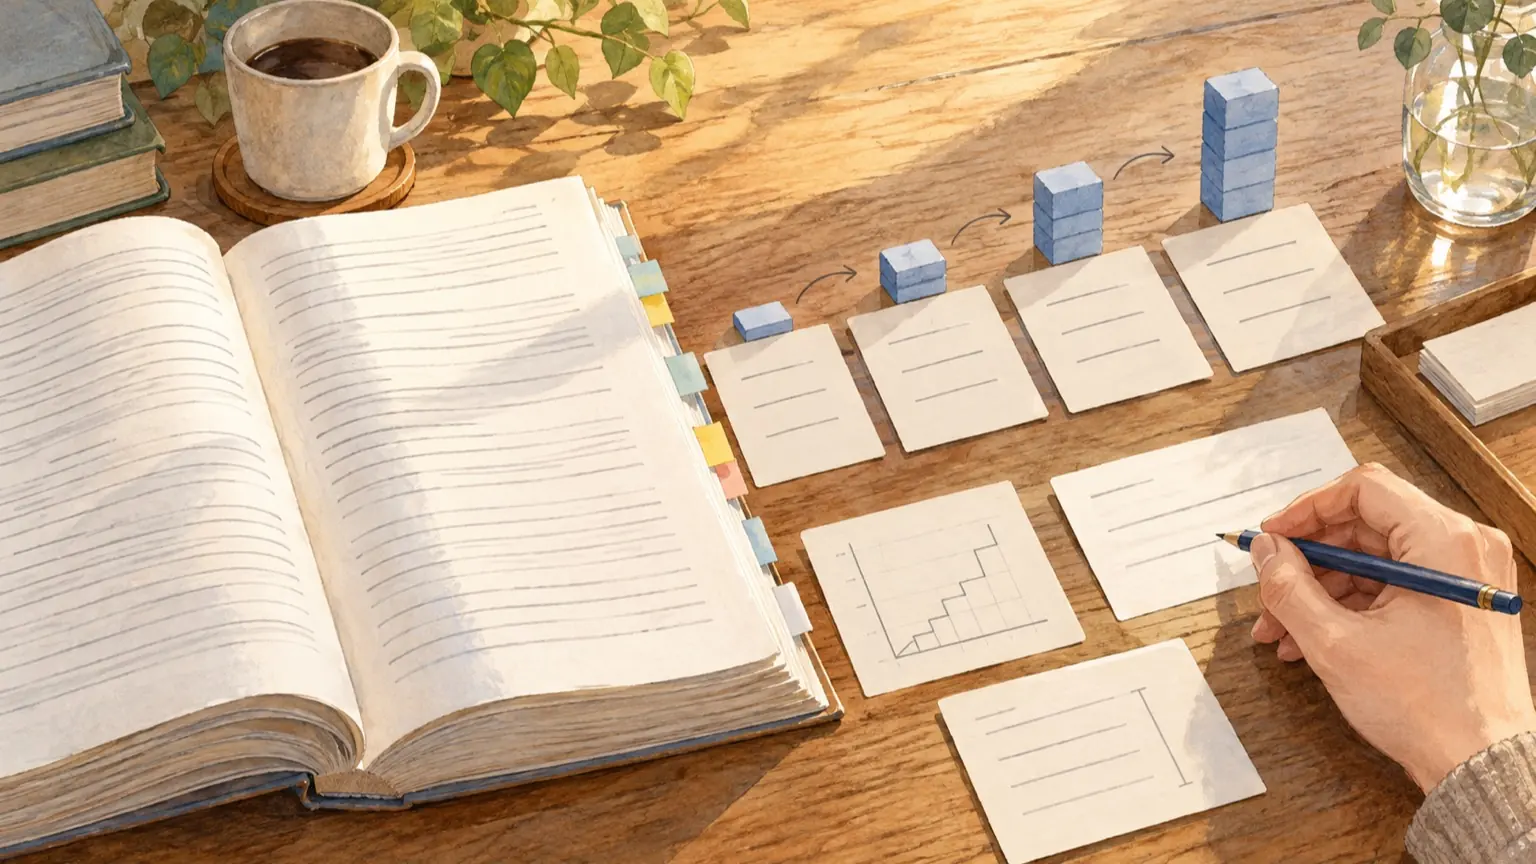
結論から言うと、コンテキスト長を伸ばすとメモリが増えるのは、モデルが「これまでに読んだ全トークンの途中計算(KVキャッシュ)」を保持するからです。保持量はトークン数にほぼ比例するので、4,096から32,768に上げれば、キャッシュ分は単純計算で8倍になります。モデル本体の重さは変わらないため、「モデルは載るのに、長文を読ませたら急に遅くなった・落ちた」という現象が起きます。 長い文書を読ませたいときは、設定を大きめに一気に上げるのではなく、次の順番で進めるのが安全です。 1. 文書と出力を合わせた必要トークン数を数える 2. キャッシュ分のメモリを概算する 3. 小さい値から段階的に上げ、各段階を記録する 以下、この手順を具体的に示します。
なぜコンテキスト長でメモリが増えるのか
Hugging Faceのキャッシュの解説によると、モデルは1トークンずつ生成し、各層で過去トークンのキーとバリューを保存して再利用します。保存が増える方向は系列長(seq_len)で、トークンが増えるたびに追記されます。同ページは、キャッシュ利用時の計算量は伸びを抑えられるが、メモリは線形に増えると説明しています。
つまり、コンテキスト長の設定は、モデルが一度に扱えるトークン数の上限です。上限を大きくすると、実行ソフトや設定によっては文書が短くてもキャッシュ用メモリを多めに確保する場合があります。実際の確保量はソフトごとに異なります。
手順1:必要なコンテキスト長を見積もる
必要な長さは次の式で見積もります。
必要トークン数 = 文書のトークン数 + 指示文・システムプロンプト + 出力の上限 + 余裕(1〜2割)
日本語は文字数からトークン数を換算する比率がモデルのトークナイザーで変わるため、固定の換算率は使わず、実際に数えるのが確実です。Ollamaなら、APIの応答に入力トークン数(prompt_eval_count)と出力トークン数(eval_count)が含まれます(Ollama API)。
次は、短い出力で入力トークン数だけを確認する呼び出し例です(未実行の例なので、モデル名と文書は置き換えてください)。
curl http://localhost:11434/api/generate -d '{
  "model": "(使うモデル名)",
  "prompt": "(文書を貼る。機密文書はダミーに置き換え)",
  "stream": false,
  "options": { "num_ctx": 32768, "num_predict": 16 }
}'
返ってきた prompt_eval_count は、実際に処理されたプロンプトの入力トークン数です。num_ctx を指定すると、リクエスト単位でコンテキスト長を指定できます。
入力が num_ctx を超えたときの扱いは、このAPIページには説明がありません。prompt_eval_count が想定より小さい場合は、文書全体が処理されたと決めつけず、分割して送り、末尾の内容についても質問して確かめてください。
手順2:キャッシュ分のメモリを概算する
1トークンあたりのキャッシュ量は、次の式で概算できます。
1トークンあたり = 2(キーとバリュー) × 層数 × KVヘッド数 × ヘッド次元 × 1要素のバイト数
層数・KVヘッド数・ヘッド次元は、モデルの設定ファイル(Hugging Faceのモデルページの config.json)で確認できます。名前はモデルによって違うことがあります。
説明用の例(実在のモデルの実測ではありません):層数32、KVヘッド数8、ヘッド次元128、f16(2バイト)と仮定します。
- 1トークン:2 × 32 × 8 × 128 × 2 = 131,072バイト(128 KiB)
- 8,192トークン:約1 GiB
- 32,768トークン:約4 GiB
- 131,072トークン:約16 GiB
この数字はキャッシュ分だけです。モデルの重みや作業用バッファは別にかかり、スライディングウィンドウ注意を使うモデルなどでは式どおりに増えません。式は「桁の見当をつける」ために使い、最終判断は次の試験で行います。
手順3:段階的に上げる試験メモ
Ollamaのコンテキスト長は、アプリの設定スライダー、または OLLAMA_CONTEXT_LENGTH=64000 ollama serve のように環境変数で変更でき、割り当て状況は ollama ps で確認できます(Ollama公式:Context length)。FAQには既定値4,096との記載があり、コンテキスト長ページにはVRAM容量に応じた既定値(24 GiB未満は4k、24〜48 GiBは32k、48 GiB以上は256k)が記載されています(FAQ)。公式ページ間で記載が異なるため、実際の割り当ては ollama ps で確かめてください。
LM Studioでも、モデルごとにコンテキストサイズ、GPUオフロード、Flash Attentionを既定値として保存できます(LM Studio公式)。
試験は、同じ文書・同じ質問で、値だけを変えて行います。下の表をコピーして、自分で埋めてください(空欄は未実施の記入欄です)。
- 1、コンテキスト長:4,096、メモリ使用量:、ollama ps のPROCESSOR:、入力トークン数:、所要時間:、末尾の質問に答えられたか:、判定:
- 2、コンテキスト長:8,192、メモリ使用量:、ollama ps のPROCESSOR:、入力トークン数:、所要時間:、末尾の質問に答えられたか:、判定:
- 3、コンテキスト長:16,384、メモリ使用量:、ollama ps のPROCESSOR:、入力トークン数:、所要時間:、末尾の質問に答えられたか:、判定:
- 4、コンテキスト長:32,768、メモリ使用量:、ollama ps のPROCESSOR:、入力トークン数:、所要時間:、末尾の質問に答えられたか:、判定:
質問は、文書の先頭・中盤・末尾から1つずつ事実確認できるものにします。例は次のとおりです。
次の文書について答えてください。
Q1. 冒頭で述べられている目的は何ですか。
Q2. 中盤の表の合計値はいくつですか。
Q3. 最後の段落の結論を一文で答えてください。
わからない場合は推測せず「文書内に記載なし」と答えてください。
判定は次の基準で記録します。
- 3問とも文書どおりに答えられ、メモリに余裕がある:その段階を採用候補にする
- 末尾の質問だけ外れる:入力が切れている可能性があるため、入力トークン数と送信文を確かめてから、一段階上げるか文書を分割する
- PROCESSORにCPU側の割合が出る、または極端に遅くなる:GPUに収まっていないため、一段階戻す
回答の正否は、必ず人が原文と照らして確認してください。
上げる代償と、減らす手段
- メモリ不足で落ちる・CPUに溢れる、考えられる原因:キャッシュ領域が増えた、試すこと:コンテキスト長を戻す、小さいモデルや軽い量子化に変える
- 速度が落ちた、考えられる原因:メモリ配置の変化、入力が長い、試すこと:段階を戻す、不要な文を削る
- 長さは足りるのに回答が粗い、考えられる原因:長文での精度低下(モデル依存)、試すこと:文書を章ごとに分けて要約し、要約を統合する
メモリを減らす設定として、Ollamaには次の2つがあります(FAQ)。
- Flash Attention:対応する環境では、コンテキストが長い場合にメモリ使用を減らせます。OLLAMA_FLASH_ATTENTION=1 で有効にできます。
- KVキャッシュの量子化:OLLAMA_KV_CACHE_TYPE で f16(既定)、q8_0(f16の約半分)、q4_0(約4分の1)を選べます。FAQは、キャッシュ型の設定が全モデルに適用される一方、GQAの多いモデルでは精度への影響が大きくなる場合があると説明しています。
量子化を使うときは、上の試験表に「キャッシュ型」の列を足し、f16 と同じ質問で答えを比べてください。
もう一つの選択肢が、そもそも長くしないことです。文書が必要量を大きく超えるなら、分割して要約し、要約を最終的に読ませる方が、設定を上げ続けるより安定する場合があります。上限を決めずに上げるのではなく、「3問に答えられる最小の段階」を採用値にするのが、この記事の考え方です。