LLMのJSON出力が壊れる場面への備え:検証・修復・再試行の流れを設計する
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
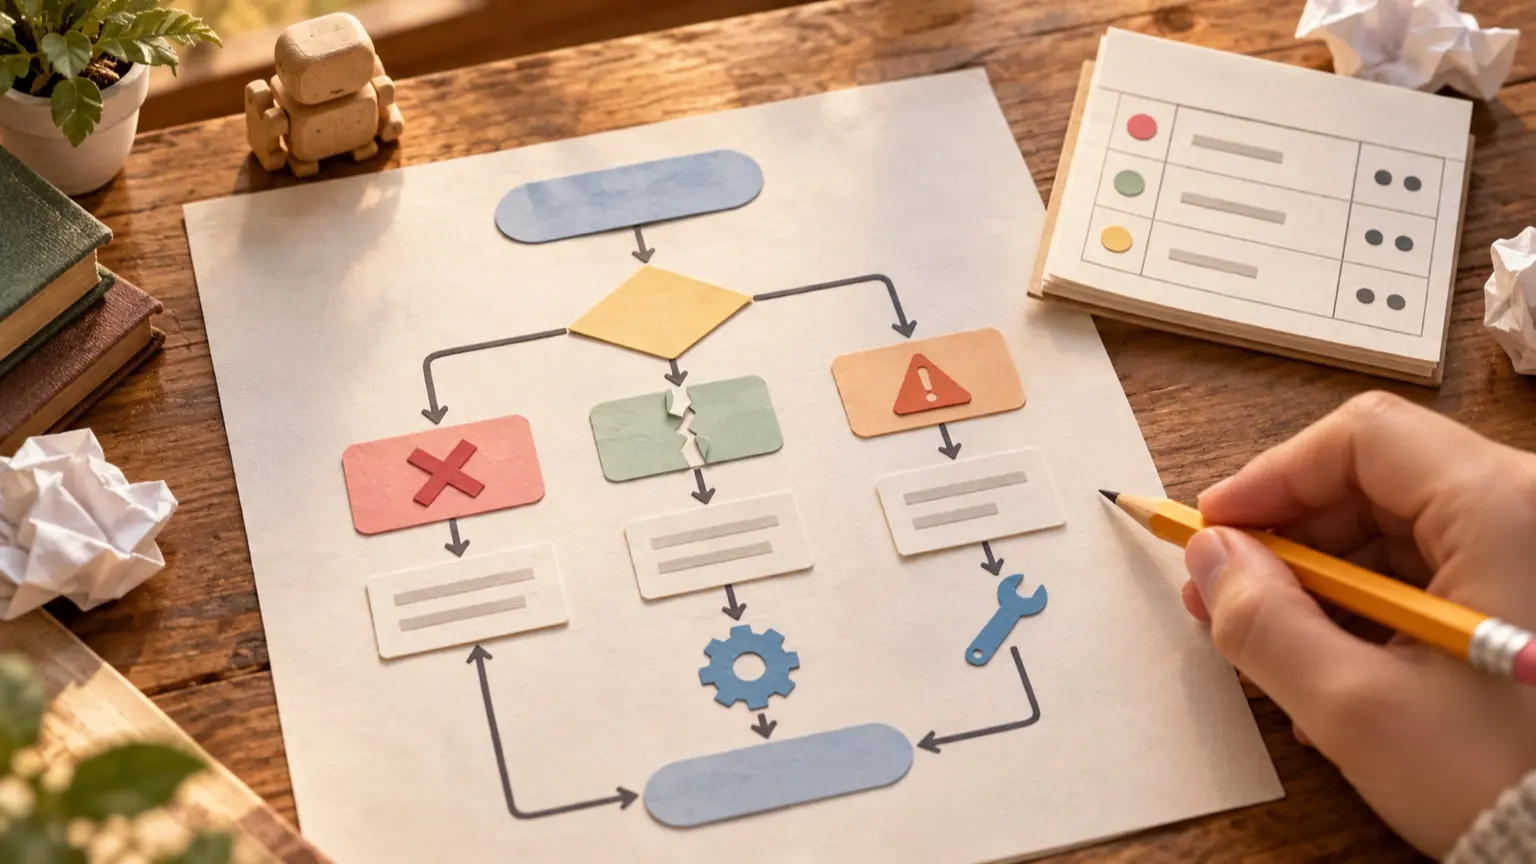
結論から言うと、「パースに失敗したら同じ依頼をもう一度送る」だけの再試行は避けたほうが安全です。失敗の原因によって、直すべき場所も再試行の効果も違うからです。スキーマ指定(Structured Outputs など)を使っても、残る失敗は大きく3つあります。 • 拒否:モデルが安全上の理由で応答を拒み、スキーマに沿った出力が返らない • 途中切れ:出力トークンの上限に達し、JSONが閉じないまま終わる • 意味の誤り:形式は正しいのに、値が業務上おかしい この記事では、失敗を種類別に振り分ける分岐フローと、再試行回数を決める判断表を示します。コードや入力例は説明用で、実行して検証した結果ではありません。
この記事の目次
まず、スキーマ指定で防げるものと防げないもの
各社の公式ドキュメントも、この線引きを前提にしています。
OpenAI はStructured Outputs のガイドで、JSON モードは有効なJSONを保証する一方でスキーマ適合までは保証せず、Structured Outputs はスキーマへの適合を扱うと説明しています。ただし拒否の場合は refusal を確認し、Responses APIで応答の status が incomplete なら incomplete_details.reason (たとえば出力トークン上限)を確認します。APIごとにレスポンス項目が異なるため、実装では使用するAPIの形式に合わせて判定します。
Anthropic はStructured Outputs のドキュメントで、stop_reason が refusal の場合と max_tokens の場合は、出力がスキーマに合わない可能性があると明記しています。enum の大文字小文字がずれて返る場合もあり、大小文字を区別せず比較し、大文字小文字だけが異なるenum値は避けるよう案内しています。minimum、maximum、minLength、maxLength などは制約から除かれる場合がありますが、SDKヘルパーが元のスキーマで応答を検証する場合は、その制約も検査されます。
Google のGemini API のドキュメントは、構文として正しいJSONが返っても、アプリ側で値を必ず検証するよう案内しています。minLength や maxLength など、制約付きデコードで強制されない項目も列挙されています。
つまり「スキーマで形は守られる。値の妥当性と、例外的な終わり方は自前で扱う」というのが共通の設計前提です。
失敗を振り分ける分岐フロー
検証は、安いチェックから順に行います。上から順に判定し、最初に当てはまった枝で処理します。
- API呼び出し自体の失敗(タイムアウト、レート制限、5xx):JSONの問題ではありません。通常の指数バックオフで別枠に扱います。
- 拒否か?(refusal フィールド、stop_reason: refusal など)→ 同じ入力の再送はしません。ユーザーへの通知か人の確認に回します。
- 途中切れか?(incomplete、max_tokens など)→ 上限を上げるか、出力を小さくして再試行します。切れたJSONの「補修」はしません。
- パースできるか?(JSONモードやスキーマなしの場合に起こります)→ コードフェンスの除去など、機械的で情報を足さない修復だけ試します。だめなら再試行します。
- スキーマ検証を通るか?(型、必須項目、未知のキー)→ エラー内容を添えて再試行します。
- 業務ルール検証を通るか?(範囲、整合性、元テキストとの一致)→ 違反箇所を指定して再試行します。それでも通らなければ人へ回します。
3を「補修しない」とする理由は、切れた位置より後ろの値が欠けているだけでなく、閉じ括弧を足して通ったように見える不完全データが下流に流れるためです。これは編集上の設計判断です。
再試行回数を決める判断表
回数は目安です。ご自身のコスト・遅延の許容と、失敗時の影響に合わせて調整してください。
- 拒否、検知の手がかり:refusal、stop_reason: refusal、同条件で再送する価値:ほぼない、試行上限の目安:0回、上限後の行き先:ユーザー通知、人の確認
- 途中切れ、検知の手がかり:incomplete、max_tokens、同条件で再送する価値:条件を変えれば高い、試行上限の目安:1回(上限引き上げ or 出力縮小)、上限後の行き先:入力を分割、または失敗扱い
- パース不能、検知の手がかり:JSONデコード例外、同条件で再送する価値:中、試行上限の目安:1〜2回、上限後の行き先:失敗扱い、ログ保存
- スキーマ違反、検知の手がかり:検証ライブラリのエラー、同条件で再送する価値:中(エラー提示で改善しやすい)、試行上限の目安:1〜2回、上限後の行き先:失敗扱い
- 意味の誤り(軽微)、検知の手がかり:範囲外、enum不一致、同条件で再送する価値:中、試行上限の目安:1回、上限後の行き先:既定値で補う or 人の確認
- 意味の誤り(重大)、検知の手がかり:金額、宛先、権限に関わる値、同条件で再送する価値:低い、試行上限の目安:0〜1回、上限後の行き先:人の確認を必須に
使い方の考え方は次のとおりです。
- 同じ入力・同じ設定の再送が効きやすいのは、出力にばらつきがある「パース不能」「軽微な意味の誤り」です。拒否や、入力そのものが原因の誤りは、何度送っても同じ結果になりがちです。
- 重大な値(金額や送信先など)は、再試行で「通った」値を信用しすぎないでください。検証を通ることと正しいことは別です。
- 全体の上限(合計3回など)も別に置くと、遅延と費用が暴走しません。
検証と再試行の骨子(説明用の例)
下の Python は流れを示す骨子で、実行確認はしていません。call_llm は各社SDKの差を吸収する自作関数を想定し、status を ok / refusal / truncated のいずれかに正規化して返す前提です。
import json

MAX_TOTAL = 3
ALLOWED = {"請求", "問い合わせ", "その他"}  # 説明用

def business_errors(d):
    errs = []
    if str(d.get("category", "")).lower() not in {a.lower() for a in ALLOWED}:
        errs.append("category が許可リスト外です")
    if not 0 <= d.get("amount", 0) <= 1_000_000:
        errs.append("amount が 0〜1,000,000 の範囲外です")
    return errs

def run(prompt, max_tokens=500):
    feedback = ""
    for attempt in range(MAX_TOTAL):
        r = call_llm(prompt + feedback, max_tokens=max_tokens)
        if r["status"] == "refusal":
            return {"result": "needs_human", "reason": "refusal"}
        if r["status"] == "truncated":
            max_tokens *= 2          # 上限引き上げ(補修はしない)
            continue
        text = r["text"].strip().removeprefix("```json").removesuffix("```").strip()
        try:
            data = json.loads(text)
        except json.JSONDecodeError as e:
            feedback = f"\n\n前回はJSONとして解析できませんでした({e.msg})。JSONのみを出力してください。"
            continue
        errs = business_errors(data)
        if not errs:
            return {"result": "ok", "data": data}
        feedback = "\n\n前回の出力は次の点が不正でした: " + " / ".join(errs)
    return {"result": "needs_human", "reason": "retry_exhausted"}
ポイントは3つあります。
- 拒否は即座に人へ回し、再送しません。
- 途中切れでは max_tokens を増やすだけで、文字列の補修はしません。
- 範囲チェックを自前で持っています。Anthropic のドキュメントでは数値や文字列長の制約がサポート対象外とされ、Gemini でも一部の制約は強制されないためです。
enum の比較に lower() を使っているのは、前述の大文字小文字のずれへの備えです。
再試行の依頼文に何を入れるか
再試行時に元のプロンプトへ足す文は、短く具体的にします。次の型が使えます(説明用の例)。
前回の出力は次の点が不正でした。
- amount が 0〜1,000,000 の範囲外です(出力値: -500)
元の入力を読み直し、該当の項目だけを修正した完全なJSONを出力してください。
入力に根拠がない項目は、推測せず null にしてください。
最後の一文が重要です。検証に通すことを優先させると、モデルが値をそれらしく作ってしまうことがあります。「根拠がなければ null」を許し、スキーマ側でも null を許容しておくと、作り話を値として通すリスクを下げられます。この点は私見による設計上の提案です。
運用で残しておく記録
失敗の種類ごとの件数が見えないと、どの枝を改善すべきか判断できません。最低限、次をログに残します。
- 失敗の分類(拒否・途中切れ・パース不能・スキーマ違反・意味の誤り)
- 試行回数と最終結果(ok / needs_human)
- 入力の識別子(個人情報や機密そのものは入れず、IDなどで参照できるようにする)
OpenAI のガイドも、スキーマ設計は評価(evals)で確かめるよう勧めています。分類別の件数は、その評価の出発点になります。特定の枝が増えたら、途中切れならスキーマや出力の縮小、意味の誤りならプロンプトと検証ルールの見直し、というように直す場所が決まります。
導入前の確認チェック
- 使っているAPIで、拒否と途中切れを検知する項目を、実際のレスポンスで確認しましたか(Gemini については、今回読んだページに終了理由の詳細がないため、SDKのレスポンス定義で確認してください)
- スキーマで強制されない制約を、アプリ側の検証に書き写しましたか
- 重大な値に、再試行とは別の人の確認経路がありますか
- 合計の試行上限と、上限後の行き先を決めましたか