小さな一覧に検索機能を付ける:ひらがな・カタカナ・全角半角の揺れまで扱う手順
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
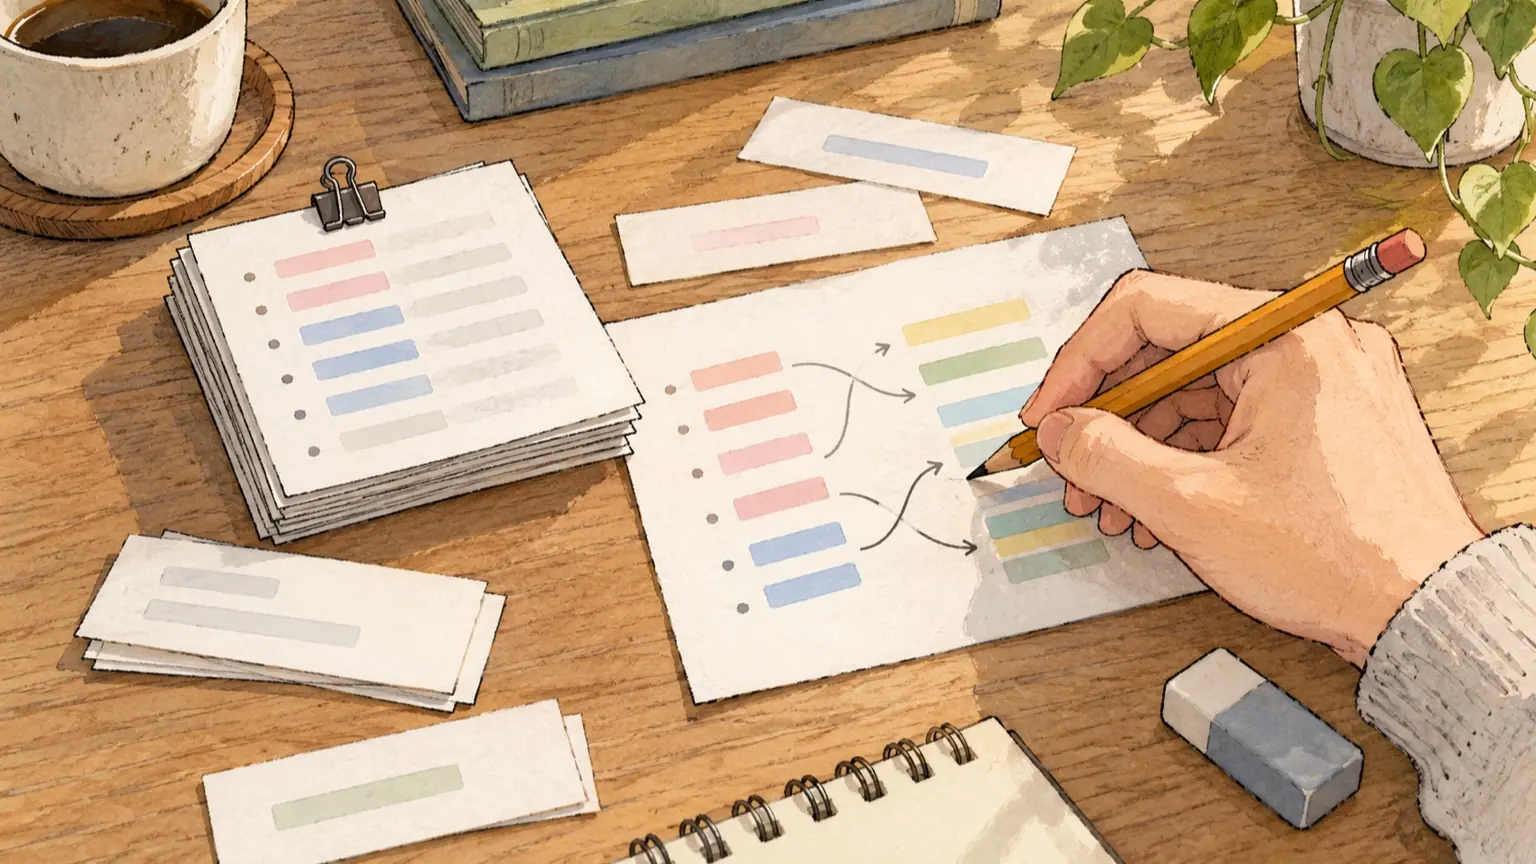
結論から言うと、サーバー無しの絞り込みでも、全角半角・英字の大文字小文字・ひらがな/カタカナの揺れは、ブラウザ標準の normalize("NFKC") と小さな変換を組み合わせれば吸収できます。一方で「東京」と「とうきょう」のような漢字と読みの違いは、文字の変換では吸収できません。これは一覧のデータ側に「読み」の欄を足して解決します。 方針は「検索する側の入力」と「検索される側のデータ」の両方を、同じ関数で『検索キー』に変換してから部分一致で比べる、というものです。この記事では、その検索キーの作り方、吸収できないものの扱い、0件のときの表示、確認用の入力例を設計メモとして並べます。 なお、この記事のコードと入力例は説明用で、私が実際のブラウザで実行して確かめたものではありません。貼り付けたら、後述の確認表で必ず自分の環境で試してください。
この記事の目次
1. どこまで吸収するかを先に決める
揺れには種類があり、機械的に直せるものと、データを足さないと直せないものがあります。最初にこの線引きを決めておくと、作り込みすぎを防げます。
- 全角/半角の英数字、例:ABC と abc、12 と 12、方法:NFKC 正規化
- 半角カタカナ、例:データ と データ、方法:NFKC 正規化
- 英字の大文字小文字、例:Tool と tool、方法:toLowerCase()
- ひらがな/カタカナ、例:ひらがな と ヒラガナ、方法:自前でひらがなに揃える
- 空白の違い、例:全角スペース、連続スペース、方法:NFKCで全角スペースを揃え、連続空白を1つにして語に分割
- 漢字と読み、例:東京 と とうきょう、方法:データに「読み」欄を追加
- 送り仮名・旧字体・長音の書き方、例:受付/受け付け、サーバ/サーバー、方法:小さな一覧では「別名欄」で対応
MDN の String.prototype.normalize() では、NFC・NFD・NFKC・NFKD の4つの正規化形式が説明されています。互換正規化(NFKC・NFKD)は、互換等価な文字列を揃えます。全角英数字や半角カタカナもNFKCで変換されるため、本記事ではこの性質を利用します。
Intl.Collator を使わない理由
Intl.Collator の sensitivity: "base" は大文字小文字などの差を無視できます。ただし MDN の Collator の説明では、usage: "search" は各項目をキーと完全一致で検査する用途とされています。部分一致にはそのまま使えず、ページにもひらがな/カタカナの扱いの説明はありません。そのため、自前の検索キー方式にしました。
2. 検索キーを作る関数
検索キー化は次の4段階です。入力にもデータにも、必ず同じ関数を通します。
- normalize("NFKC"):全角英数・半角カタカナ・全角スペースなどを揃える
- toLowerCase():英字を小文字に
- カタカナ(U+30A1〜U+30F6)をひらがなに変換:コードを 0x60 引くとひらがなになるのを利用(この範囲外の文字は対象外です)
- 空白を整える
const toKey = (s) =>
  s.normalize("NFKC").toLowerCase()
    .replace(/[\u30a1-\u30f6]/g, (c) =>
      String.fromCharCode(c.charCodeAt(0) - 0x60))
    .replace(/\s+/g, " ").trim();
ひらがなに揃えるのは、読みの欄をひらがなで書く運用が楽だからです。カタカナ側に揃えても構いませんが、どちらかに統一してください。
3. 一覧に「読み」「別名」を持たせる
検索対象は、表示名だけでなく、読み・別名・タグをつなげた文字列にします。次は説明用の例です(実在のデータではありません)。
<input id="q" type="search" placeholder="名前・読みで絞り込み">
<p id="count" role="status"></p>
<ul id="list"></ul>
<p id="empty" hidden></p>
<script>
const items = [
  { name: "東京タワー", yomi: "とうきょうたわー", alias: "Tokyo Tower" },
  { name: "データ整理ツール", yomi: "でーたせいり", alias: "データ せいり" },
  { name: "AI議事録", yomi: "えーあいぎじろく", alias: "AI ぎじろく" },
  { name: "サーバー設定メモ", yomi: "さーばーせってい", alias: "サーバ" },
].map((it) => ({ ...it, key: toKey([it.name, it.yomi, it.alias].join(" ")) }));

const q = document.getElementById("q");
const list = document.getElementById("list");
const empty = document.getElementById("empty");
const count = document.getElementById("count");

function render() {
  const words = toKey(q.value).split(" ").filter(Boolean);
  const hit = items.filter((it) => words.every((w) => it.key.includes(w)));
  list.replaceChildren(...hit.map((it) => {
    const li = document.createElement("li");
    li.textContent = it.name; // textContentで入れて、HTMLとして解釈させない
    return li;
  }));
  count.textContent = `${hit.length}件 / 全${items.length}件`;
  empty.hidden = hit.length > 0;
  if (!hit.length) empty.textContent = `「${q.value}」に合うものはありません。読みや別の言い方でも試せます。`;
}
q.addEventListener("input", render);
render();
</script>
(toKey は上の関数を同じ <script> の先頭に置いてください。)ポイントは3つです。
- スペース区切りの AND 検索:「データ せいり」のように語を分けても、すべての語を含む項目だけが残ります。
- キーは起動時に一度だけ作る:入力のたびにデータ側を変換しなくて済みます。数十〜数百件規模ならこれで十分です。
- 表示は textContent:入力文字をそのまま innerHTML に入れると表示崩れや脆弱性の原因になります。
IME での変換中も input イベントは発生します。MDN の input イベントによれば、変換中のイベントでは isComposing が true になります。小さな一覧なら変換中も絞り込んで問題ありませんが、重く感じる場合は e.isComposing が true の間だけ処理を飛ばす選択肢があります。
4. 吸収できないものと0件時の表示
文字の変換で吸収できないものは、無理に自動化せず、2つの出口を用意します。
- データ側の出口:読み欄・別名欄を足す。上の例の「サーバ」のような表記違いは、別名欄に書いておけば拾えます。
- 画面側の出口:0件のとき、何も出さずに空白にしない。
0件表示で入れておきたい要素は次のとおりです。
- 入力した語をそのまま見せる(打ち間違いに気づける)
- 次の手を示す(読みや別の言い方、短い語で試す)
- 解除の手段を置く(入力を消す、または全件に戻す)
- 件数を role="status" の要素に出す(読み上げ環境にも変化が伝わりやすい)
「該当なし」の一言だけにすると、利用者は表記が違っただけなのか、本当に無いのか判断できません。
5. AI に任せる部分と人が確認する部分
読み欄や別名欄の作成、確認用の入力例の洗い出しは AI が得意な作業ですが、読みの間違いはそのまま検索漏れになります。分担は次のとおりです。
- 読み(ひらがな)の下書き、AI:任せる、人:固有名詞・人名は必ず目で確認
- 別名・表記違いの候補出し、AI:任せる、人:実際に利用者が使う言い方だけ残す
- 確認用の入力例の作成、AI:任せる、人:期待する結果を自分で決める
- コードの動作確認、AI:補助、人:ブラウザで表の入力を実際に打つ
AI への依頼文の例です。データは機密を含まない説明用のものに置き換えて渡してください。
次の一覧の各行に、ひらがなの「yomi」と、表記違いを集めた「alias」を付けた
JavaScript配列にしてください。
- yomi は全部ひらがな、長音は「ー」のまま
- alias は、全角/半角、送り仮名、略称など利用者が打ちそうな別表記
- 読みに自信がない行には "要確認" と書いた別の配列に分けてください
一覧:
1. (ここに名前を1行ずつ)
「自信がない行を分ける」と指定しておくと、人が見るべき箇所が絞れます。
6. 確認用の入力例(設計メモ)
次の表は、上の説明用データに対して期待する結果です。実行して確かめた結果ではないので、貼り付けた後に1行ずつ打って、食い違いがあれば toKey かデータを直してください。
- tokyo、TOKYO、期待する結果:東京タワー、見たい点:大文字小文字・全角英字
- とうきょう / トウキョウ、期待する結果:東京タワー、見たい点:ひらがな/カタカナ
- データ、期待する結果:データ整理ツール、見たい点:半角カタカナ(濁点付き含む)
- データ せいり(全角スペース)、期待する結果:データ整理ツール、見たい点:空白の正規化と AND 検索
- ai、期待する結果:AI議事録、見たい点:全角のデータ側も揃うか
- サーバ、期待する結果:サーバー設定メモ、見たい点:別名欄の効果
- さーばー、期待する結果:サーバー設定メモ、見たい点:長音を含む読み
- 東京 たわ、期待する結果:東京タワー、見たい点:名前の漢字と読み欄の混在
- (空欄)、期待する結果:全4件、見たい点:全件に戻るか
- ぜんぜん無い語、期待する結果:0件表示と文言、見たい点:入力語が表示されるか
濁点の扱いやカタカナの範囲は、文字種によって差が出やすい部分です。表の「半角カタカナ」と「長音」の行は特に念入りに試してください。
運用の目安
検索が必要になる一覧は、増えるたびに表記違いが増えます。新しい項目を足すときは「名前・読み・別名」の3点セットで入れる、というルールを決めておくのが、いちばん効く対策です。数千件を超えて遅くなってきたら、その時点で検索ライブラリやサーバー側検索を検討すれば間に合います。