AIは次の言葉をどう選んでいるのか:答えが毎回変わる仕組みを例文で理解する
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
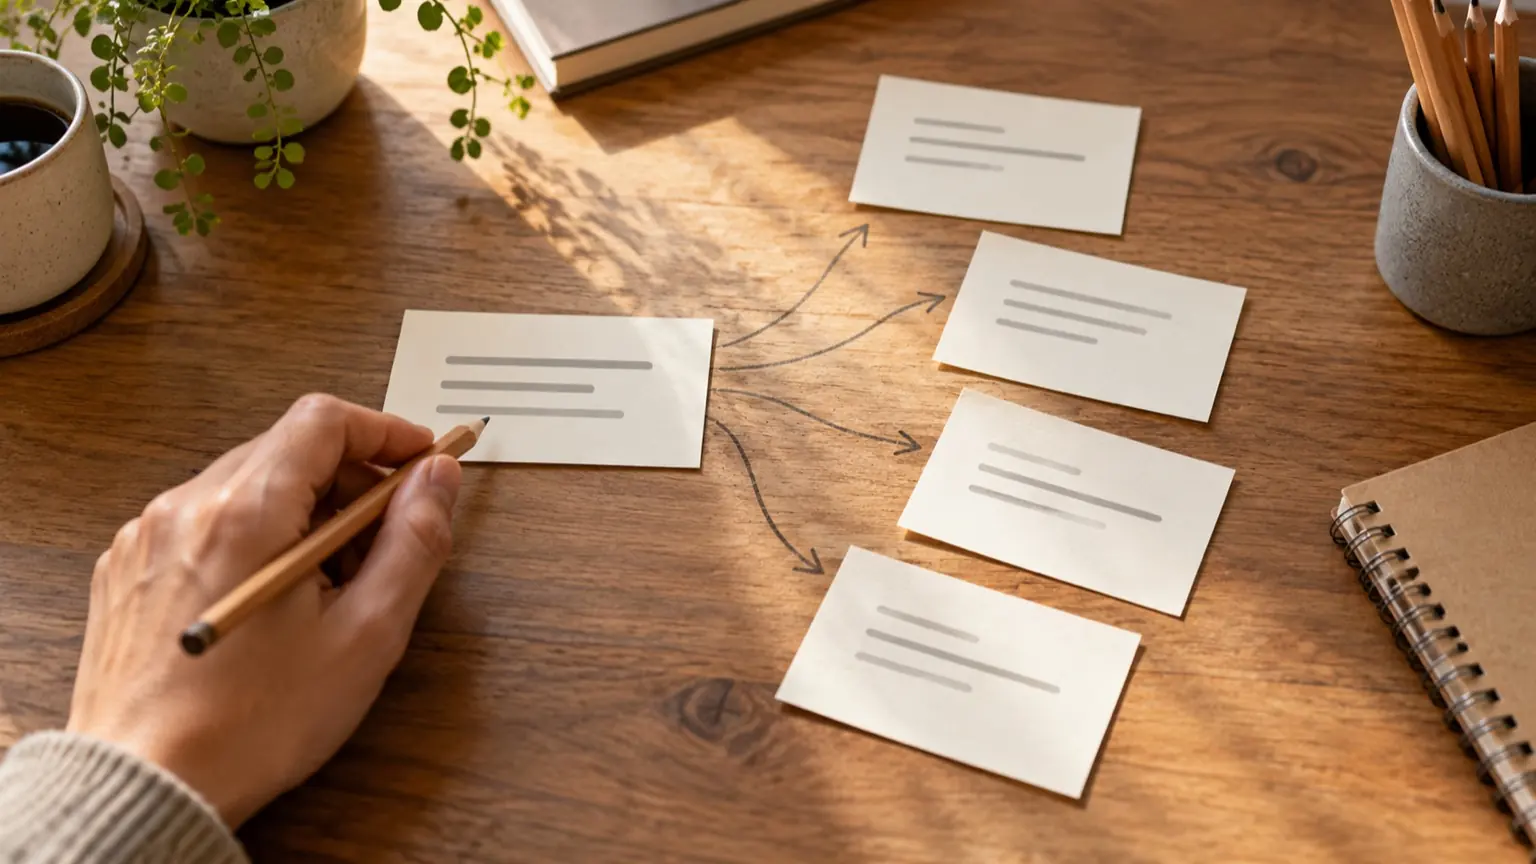
同じ質問を投げても、生成AIの答えは毎回少しずつ違います。理由を先に言うと、AIは「正解の一語」を1つ決めて出しているのではなく、次に来そうな言葉の候補それぞれに確率を割り当て、その中から1つを選んで、また次を選ぶ、という作業を繰り返しているからです。選ぶ段階にくじ引きのような要素があるので、途中で別の言葉が選ばれると、そこから先の文章も別の道をたどります。 OpenAIのAPIリファレンスでは、出力のランダムさを調整する設定として、temperature(値が高いほど出力がよりランダムに、低いほどより集中的で決定的になる)と、top_p(確率の上位から合計が一定になる範囲のトークンだけを考慮する方式)が説明されています(OpenAI API リファレンス:Completions)。この記事では、その意味を短い例文で追い、最後にぶれに関する用語を読み替える表を付けます。 なお、以下の確率や続きの文はすべて説明用の例です。特定のAIで測った数字ではありません。
この記事の目次
次の言葉は「確率つきの候補リスト」から選ばれる
AIが扱う単位は厳密には単語ではなく「トークン」と呼ばれる文字のかたまりですが、ここでは分かりやすく「言葉」と書きます。
書き出しを「週末は、」として、次の言葉の候補に次のような確率がついていたとします(説明用の例)。
- 家で、確率(例):40%、上位からの累積:40%
- 友人と、確率(例):25%、上位からの累積:65%
- 雨の、確率(例):15%、上位からの累積:80%
- 出かけ、確率(例):12%、上位からの累積:92%
- その他すべて、確率(例):8%、上位からの累積:100%
「家で」が最有力ですが、60%の確率ではほかの言葉が選ばれます。くじを引くたびに結果が変わりうるので、同じ質問でも答えが揺れます。OpenAIのドキュメントも、Chat Completionsは既定では非決定的で、リクエストごとに出力が異なりうると説明しています(OpenAI Cookbook:seedパラメータ)。
同じ書き出しから複数の続きが出る例文表
一度選ばれた言葉は、次の候補の確率に影響します。「家で」を選べば次は「ゆっくり」「映画を」が有力になり、「友人と」を選べば「食事に」「会う」が有力になります。分かれ道が連鎖するので、最初の1語の違いが文全体の違いになります。
書き出し「週末は、」から3回生成したと仮定した例です(説明用の例であり、実際の出力ではありません)。
- 1回目、1語目に選ばれた言葉:家で(40%の候補)、続きの文(例):週末は、家でゆっくり映画を見て過ごす予定です。
- 2回目、1語目に選ばれた言葉:友人と(25%の候補)、続きの文(例):週末は、友人と食事に行く約束があります。
- 3回目、1語目に選ばれた言葉:雨の(15%の候補)、続きの文(例):週末は、雨の予報なので外出を控えます。
1回目は最有力の候補が選ばれ、2回目と3回目は確率の低い候補が選ばれています。どれも文として自然で、間違いではありません。「ぶれ」は故障ではなく、候補の中から選ぶ仕組みの当然の結果です。
事実を問う質問でも、質問の仕方や使う情報、生成時の設定によって答えが変わることがあります。候補から選ぶ仕組みだけで、ぶれやすさを一律には予測できません。
自分で確かめる手順
次の依頼文を、新しいチャットで3回送ってみてください(結果はこの記事では実施していません)。
次の書き出しの続きを、30字以内で1文だけ書いてください。
書き出し:「週末は、」
3つの続きを並べ、1語目が同じか違うかを見ると、どこで道が分かれたかが分かります。1語目が同じなのに後半が違うなら、2語目以降の別の分かれ道で差が出ています。
temperatureとtop_pは「候補の選び方」を変える
先ほどの表を使って、2つの設定の考え方を説明します。数値は引き続き説明用です。
temperature(温度)は、確率の差をどれだけ強調するかのつまみです。OpenAIの説明では、高いほど出力がランダムに、低いほど集中的で決定的になります。たとえば低くすると、候補の確率が「家で 55%、友人と 25%、雨の 10%…」のように最有力へ偏り、高くすると「家で 30%、友人と 25%、雨の 20%…」のように差が縮まります(いずれも例)。
top_pは、確率の高い順に足していき、合計が指定値に達するところまでの候補だけを残す方式です。表で top_p を0.7とすると、累積が70%を超える「家で・友人と・雨の」の3つが残り、「出かけ」などの低確率の候補は最初から除外されます。公式の説明では temperature の代替手段にあたる「nucleus sampling」と呼ばれています(同リファレンス)。
この「確率の低い尾の部分を切る」考え方は、研究でも扱われています。Holtzmanらの論文は、最も確率の高い列を狙う生成は退屈で繰り返しの多い文になりやすいこと、nucleus samplingは多様さを保ちつつ信頼性の低い裾野を切れることを論じています(The Curious Case of Neural Text Degeneration(arXiv論文))。つまり、毎回同じ最有力の言葉だけを選べばよい、というわけでもないのです。
ぶれに関する用語の読み替え表
資料や設定画面で出会う言葉を、日常の言い方に置き換えます。
- 非決定的(non-deterministic)、読み替え:同じ入力でも出力が変わりうる、この記事の例では:「週末は、」から3通りの続きが出る
- temperature、読み替え:候補の確率の差を強調・緩和するつまみ、この記事の例では:低いと「家で」に偏る
- top_p、読み替え:上位から足して、範囲外の候補を足切りする線、この記事の例では:0.7なら3候補だけが残る
- seed、読み替え:くじ引きの「種」。同じ種なら同じ引き方を試みる、この記事の例では:同じ種・同じ設定で再現を狙う
- system_fingerprint、読み替え:裏側の構成を識別する印、この記事の例では:印が変われば、同じ種でも結果が変わりうる
- logprobs、読み替え:選ばれたトークンと上位候補の対数確率情報、この記事の例では:表の「確率」列を作る参考情報に相当
seedについては注意があります。OpenAIの説明では、seedを指定すると「ベストエフォートで」決定的にサンプリングしようとするだけで、同じ結果は保証されません。バックエンドの変更で決定性が影響を受けうるため、system_fingerprintで変化を追う設計です(OpenAI Cookbook:seedパラメータ、OpenAI Advanced usage)。このCookbookのページはアーカイブ扱いで、当時のseed機能は特定モデルのベータ提供と記載されています。現在の対応モデルについては、このページからは確認できません。
ニュースや記事で「毎回違う」を読むときの判断表
「AIに同じ質問をしたら答えが違った」という話を見たとき、仕組みから次のように切り分けられます。
- 言い回しや構成が違う、仕組みからの読み方:候補からの選択による通常のばらつき
- 事実や数字が食い違う、仕組みからの読み方:候補選びのぶれだけでなく、根拠となる情報の有無や質問の曖昧さも疑う。出典で確認する
- 「温度を0にしても違った」、仕組みからの読み方:設定が同じでも、公式がベストエフォートと述べる範囲。裏側の構成の変更も要因になりうる
- 「一度だけ試して断言している」、仕組みからの読み方:1回の出力は、確率的な選択の1サンプルにすぎない
最後の行が実用上は大切です。1回の出力だけで「AIはこう答える」と結論づけるのは、サイコロを1回振って出目の傾向を語るのに近いと言えます。
まとめ
答えが毎回変わるのは、AIが確率つきの候補から次の言葉を選び、その選択が連鎖して文全体が変わるためです。temperatureとtop_pは、その選び方の幅を調整する設定で、seedは再現を試みる仕組みですが、完全な一致は保証されません。確かめたいときは、上の依頼文を3回送って、どこで道が分かれるかを見てみてください。