正解率95%でも使えない?scikit-learnで偏ったデータの評価指標を読み解く
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
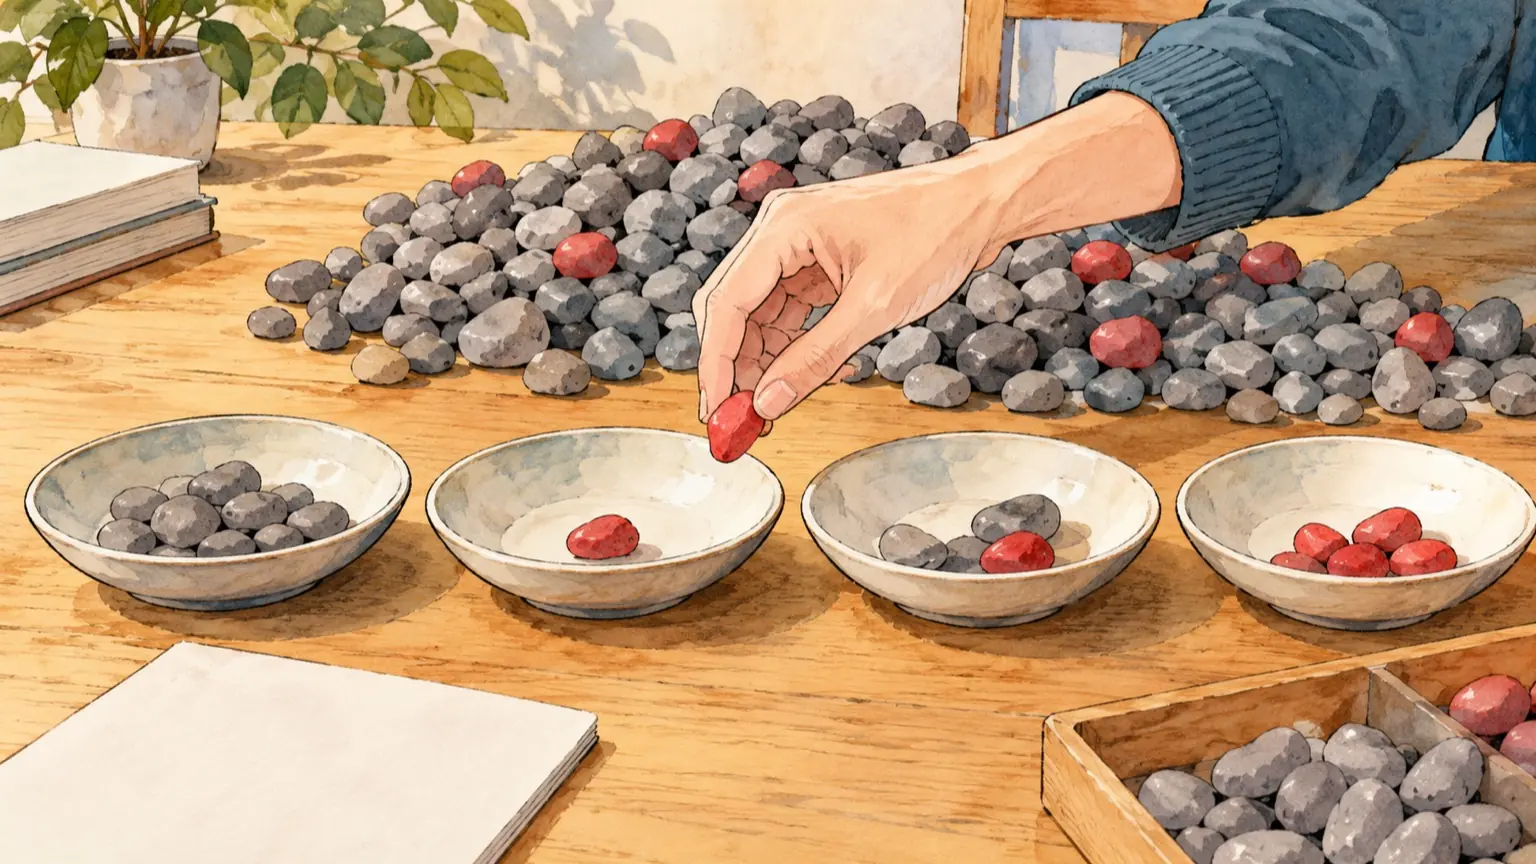
結論から言うと、片方のクラスが少ないデータでは、正解率95%は「良いモデル」の証拠になりません。たとえば陽性が5%しかなければ、全件を「陰性」と答えるだけで正解率は95%になります。見るべきなのは、少ないほうのクラスについての再現率(取りこぼしの少なさ)と適合率(陽性と言ったときの当たりやすさ)です。この2つを混同行列から手計算できれば、scikit-learnの出力は迷わず読めます。 この記事では、架空の混同行列で手計算し、そのあとscikit-learnで同じ値を出すコードと、指標の選び分け表を示します。 この記事の数値とコードは、すべて説明用の例です。実際のデータやモデルで測った結果ではありません。コードも、この記事の執筆時点では実行確認をしていません。お手元の環境で動かして、手計算の値と一致するか確かめてください。
混同行列の4マスを先に確認する
二値分類の結果は、実際の値と予測の組み合わせで4つに分かれます。陽性を「見つけたい少数派」とします。
- 実際:陰性、予測:陰性:TN(正しく陰性)、予測:陽性:FP(誤って陽性と判定)
- 実際:陽性、予測:陰性:FN(見逃し)、予測:陽性:TP(正しく陽性)
scikit-learnのconfusion_matrixは、行が実際のクラス、列が予測のクラスです。二値の場合、陰性・陽性の順に行と列が並ぶ2×2の行列なら、.ravel()でtn, fp, fn, tpの順に取り出せます。この記事のコードでは陰性を0、陽性を1としています。この並びは公式ドキュメントのconfusion_matrixに例つきで載っています(確認したのは1.9.1版のページです)。
各指標の定義はモデル評価のガイドにある次の式です。
- 正解率 = 当たった数 ÷ 全体
- 適合率(precision) = TP ÷ (TP + FP)
- 再現率(recall) = TP ÷ (TP + FN)
- F1 = 適合率と再現率の調和平均
手計算:正解率が同じ95%でも中身は別物
説明用の例として、1,000件のうち陽性が50件(5%)のデータを考えます。3つのモデルA・B・Cがあるとします。
- A:常に「陰性」と答える、TN:950、FP:0、FN:50、TP:0
- B:そこそこ拾う、TN:920、FP:30、FN:20、TP:30
- C:多めに陽性と言う、TN:860、FP:90、FN:10、TP:40
モデルA:正解率95%なのに何も見つけていない
- 正解率 = (950 + 0) ÷ 1,000 = 0.95
- 再現率 = 0 ÷ (0 + 50) = 0
- 適合率 = 0 ÷ (0 + 0) となり、そもそも計算できません
陽性を一件も当てていないのに、正解率だけ見れば優秀に見えます。これが「正解率95%でも使えない」の正体です。なお、分母が0になる場合、classification_reportのzero_division引数の既定値"warn"は0として扱いつつ警告を出します(classification_reportのページ)。警告が出たら「陽性を一度も予測していない」可能性を疑ってください。
モデルB:同じ正解率95%で、ようやく中身がある
- 正解率 = (920 + 30) ÷ 1,000 = 0.95
- 適合率 = 30 ÷ (30 + 30) = 0.50
- 再現率 = 30 ÷ (30 + 20) = 0.60
- F1 = 2 × 0.50 × 0.60 ÷ (0.50 + 0.60) ≒ 0.545
陽性と判定したものの半分は外れで、本物の陽性の4割は見逃しています。それでも、Aと正解率は同じです。正解率だけでは、AとBの差が見えません。
モデルC:正解率は下がるが、見逃しは減る
- 正解率 = (860 + 40) ÷ 1,000 = 0.90
- 適合率 = 40 ÷ (40 + 90) ≒ 0.31
- 再現率 = 40 ÷ (40 + 10) = 0.80
正解率はBより5ポイント低いのに、再現率は0.60から0.80に上がっています。見逃しのコストが大きい用途なら、Cのほうが適切な場合があります。逆に、誤検知への対応に人手がかかる用途ならBが向くかもしれません。どちらが良いかは、FPとFNのどちらが痛いかで決まります。
補助的な指標:balanced accuracy
陽性・陰性それぞれの再現率の平均が、balanced accuracyです。二値では(感度 + 特異度) ÷ 2で、不均衡データで成績が水増しされるのを避ける目的の指標だと公式ガイドに説明があります。説明用の例では次のようになります。
- A:(0 + 950÷950) ÷ 2 = 0.50
- B:(0.60 + 920÷950) ÷ 2 ≒ 0.78
- C:(0.80 + 860÷950) ÷ 2 ≒ 0.85
Aが0.50と出るため、「何も見分けていない」ことが一目で分かります。ただし、FPの多さ(適合率)は直接は反映されないので、これ単独で決めないでください。
scikit-learnで同じ値を出す
次のコードは、上の3パターンの件数から配列を作って指標を出す、説明用の例です(未実行)。
import numpy as np
from sklearn.metrics import (
    confusion_matrix, accuracy_score, precision_score,
    recall_score, f1_score, balanced_accuracy_score,
)

def make_labels(tn, fp, fn, tp):
    y_true = np.array([0] * (tn + fp) + [1] * (fn + tp))
    y_pred = np.array([0] * tn + [1] * fp + [0] * fn + [1] * tp)
    return y_true, y_pred

cases = {
    "A": (950, 0, 50, 0),
    "B": (920, 30, 20, 30),
    "C": (860, 90, 10, 40),
}

for name, counts in cases.items():
    y_true, y_pred = make_labels(*counts)
    tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel().tolist()
    print(name, (tn, fp, fn, tp))
    print("  accuracy ", accuracy_score(y_true, y_pred))
    print("  precision", precision_score(y_true, y_pred, zero_division=0))
    print("  recall   ", recall_score(y_true, y_pred))
    print("  f1       ", f1_score(y_true, y_pred, zero_division=0))
    print("  balanced ", balanced_accuracy_score(y_true, y_pred))
期待する値は、上の手計算のとおりです(Aの適合率はzero_division=0により0と表示されます)。一致しない場合は、confusion_matrixの並びを取り違えていないか確認してください。
実データではclassification_report(y_true, y_pred)を使うと、クラスごとの適合率・再現率・F1と件数(support)がまとめて出ます。見る行は、少数派クラス(多くの場合ラベル1)の行です。末尾のaccuracyやweighted avgは多数派に引っ張られやすいので、先にsupportの偏りを確認してください。macro avgは各クラスを同じ重みで平均するため、少数派の悪さが埋もれにくくなります(model_evaluationの平均化の説明)。
指標の選び分け表
下表は公式の定義を踏まえた編集上の目安です。業務の事情で優先順位は変わります。
- 見逃しが重大(不具合・不正の検知など)、まず見る指標:再現率、理由:FNを減らしたい、注意点:上げすぎるとFPが増え、適合率が下がる
- 誤検知の対応コストが重い(自動で人に通知する等)、まず見る指標:適合率、理由:FPを減らしたい、注意点:厳しくしすぎると見逃しが増える
- 両方をバランスよく見たい、まず見る指標:F1、理由:適合率と再現率の調和平均、注意点:一方が極端に低いと値が大きく下がる。TNは考慮しない
- 少数派・多数派の両方の見分けを1つの数字で、まず見る指標:balanced accuracy、理由:クラスごとの再現率の平均、注意点:FPの多さは直接見えない
- 判定のしきい値を決める前にモデルを比べたい、まず見る指標:average precision、理由:スコアの出し方そのものを評価、注意点:確率やスコアが必要(predict_probaなど)。ランダムなら陽性率に近い値になる
- クラスがほぼ半々、まず見る指標:正解率でも可、理由:偏りの影響が小さい、注意点:それでも混同行列は確認する
しきい値を動かすと、適合率と再現率は一方が上がれば他方が下がる関係になりやすいです。モデルBとCの違いはその一例と考えられます。比較するときは、同じ評価データ、同じ指標で並べてください。
判断の手順と、AIに頼むときの渡し方
- 評価データの陽性率を確認する(件数の比を見るだけです)
- 混同行列の4つの数を出す
- 「見逃し」と「誤検知」のどちらが業務上重いかを、人が決める
- 3に合う指標(再現率か適合率)を主に、F1やbalanced accuracyを補助に見る
- 正解率は「参考値」に下げる
手順3はAIに任せず、人が決める部分です。一方、手計算の検算や表の読み解きはAIに頼めます。渡すのは件数だけで十分です。実際の顧客データや個票は渡さず、説明用の数値に置き換えてください。
次の混同行列は説明用の数値です。
TN=920, FP=30, FN=20, TP=30(陽性が少数派)
1. 正解率・適合率・再現率・F1を、式と途中計算つきで示してください。
2. 「見逃しが重大」と「誤検知が重い」の2つの場面で、
   どの指標を優先すべきかを理由つきで説明してください。
3. 私の手計算(適合率0.50、再現率0.60)と違う点があれば指摘してください。
返ってきた数値は、自分でもう一度割り算して確かめてください。AIの計算は間違うことがあるため、コードの出力と照らし合わせるのが確実です。