アンケートの自由記述を分類する手順:読み込みからカテゴリ作成、集計まで
AIを使いこなすClaudeで執筆し、GPTで自動校閲・修正しています。
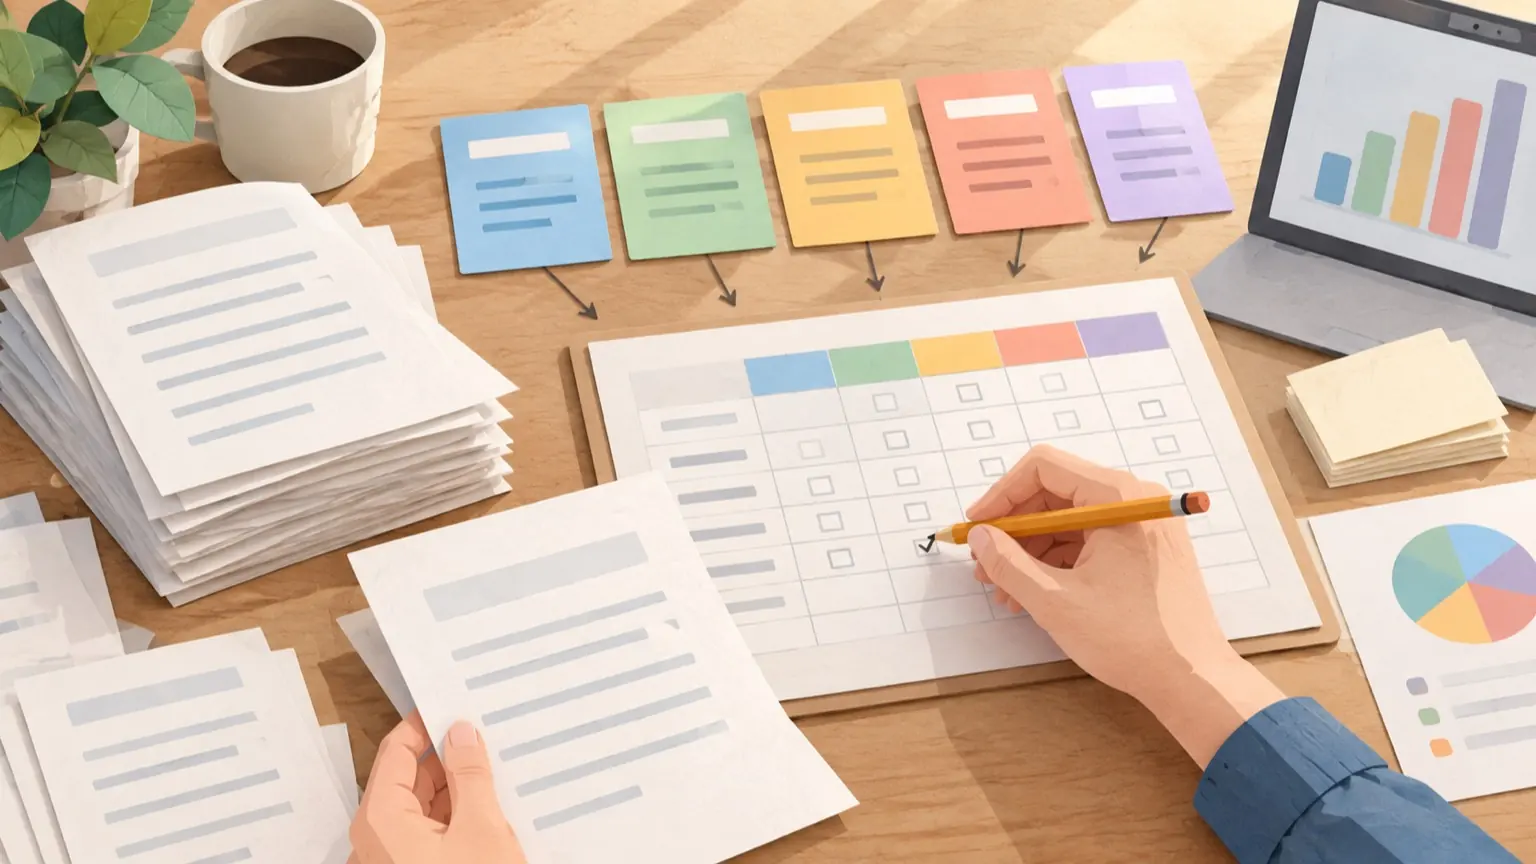
自由記述を後から再確認できる形で分類するには、「原本を変えない」「カテゴリの定義を文章で残す」「回答ごとの分類結果を表で残す」の3点を守ります。流れは次の5段階です。 1. 原本を読み込み、回答IDを固定する 2. 一部を読んでコードブック(カテゴリ定義表)を作る 3. コードブックに沿って仮分類する(AIに任せてもよい) 4. 人が確認し、修正を記録してから件数を集計する 5. 代表例を決まった基準で選ぶ この記事の表とコードは、すべて「説明用の例」です。実際に実行した結果や調査結果ではありません。コードは未実行の雛形なので、自分のファイルの列名に合わせて動作を確かめてください。
この記事の目次
手順1:原本を触らずに読み込み、回答IDを固定する
最初にやるのは分類ではなく、回答と回答IDの対応を固定することです。後から「この分類はどの回答のものか」を追えなくなると、再確認ができません。
読み込みでは次の点に注意します。
- 原本のCSVは上書きせず、分類用のファイルを別に作る
- 空欄を「欠損」に変換させない。pandasのread_csvは初期設定で特定の文字列をNaN(欠損)として扱います。keep_default_na=Falseにすると、na_valuesを指定しない限り文字列は欠損扱いになりません。「NA」「なし」といった短い回答も残せます
- 回答IDはdtypeで文字列にして、先頭の0が消えないようにする
import pandas as pd

df = pd.read_csv(
    "survey.csv", encoding="utf-8",
    usecols=["回答ID", "自由記述"],
    dtype={"回答ID": str, "自由記述": str},
    keep_default_na=False,
)
df["自由記述"] = df["自由記述"].str.strip()

blank = df["自由記述"] == ""
print("総数", len(df), "空欄", blank.sum())
df = df[~blank]          # 空欄は集計対象外として件数だけ記録する
df.to_csv("work_input.csv", index=False, encoding="utf-8-sig")
出力される「総数」と「空欄」の数は、後で集計表の分母を説明するために記録表へ書き留めます。
手順2:コードブックを作ってからカテゴリを確定する
全件を読む前に、まず少数をランダムに読んでカテゴリ案を作ります。先頭から読むと回答時期や並び順の偏りを拾うので、ランダムに選ぶ方が安全です。件数は回答数に応じて調整してください。目安として、数百件なら50件前後から始めると、おおまかな型が見えます。
カテゴリは名前だけでなく、含める基準・含めない基準・例をセットで書きます。これがコードブックです。
- 価格、含める:料金・費用・値上げへの言及、含めない:「コスパ」だけで品質を語る文、例(説明用):「月額が高い」
- 使いやすさ、含める:操作・画面・設定のしやすさ、含めない:機能の有無そのもの、例(説明用):「ボタンが探しにくい」
- 機能要望、含める:追加・改善してほしい機能、含めない:不具合の報告、例(説明用):「CSV出力がほしい」
- 不具合、含める:動作不良・エラー、含めない:操作が分かりにくいだけの文、例(説明用):「保存で落ちる」
- その他、含める:どれにも当てはまらない、含めない:―、例(説明用):「特になし」
コードブックを作るときのルールを決めておきます。
- 1回答につき主カテゴリは1つにする(複数に触れる回答は、副カテゴリ列を別に設ける)
- 「その他」が全体の2〜3割を超えたら、カテゴリ案が粗すぎると考えて見直す(これは編集上の目安です)
- 修正したら日付と理由を変更ログに残し、修正前の分類をやり直す
手順3:AIに仮分類を任せる場合の依頼文と渡し方
件数が多いときは、AIに仮分類をさせて人が確認する方法が現実的です。ここでAIに任せるのは「コードブックに当てはめる作業」までで、カテゴリ定義そのものや最終判断は人が持ちます。
渡すもの
- コードブック(上の表)
- 回答IDと自由記述だけの表(氏名・メールアドレス・会社名などは事前に削除または置換)
- 出力形式の指定
ChatGPTにファイルを添付する場合、CSVやスプレッドシートのサイズ上限は、OpenAIのヘルプ(Uploading files and audio to ChatGPT)で「行の大きさにより約50MB」とされています。同ページには、3時間あたり最大80ファイル、Freeプランは1日3ファイルまでという記載があり、ピーク時は上限が下がる可能性にも触れています。これらの上限や利用条件は変わることがあるため、利用前に最新の記載を確認してください。
なお、学習に利用されない設定と、情報を外部に出してよいかという秘密保持の判断は別の問題です。顧客の氏名や社内の固有名詞が混ざる場合は、AIに渡す前に「顧客A」「製品X」のように置き換えます。調査時に回答者へ伝えた利用目的の範囲も確認してください。
依頼文の例
添付のコードブックに従い、添付CSVの自由記述を分類してください。

条件:
- 主カテゴリはコードブックのカテゴリ名から1つだけ選ぶ
- コードブックにない新しいカテゴリは作らない。当てはまらなければ「その他」
- 根拠になった語句を原文から抜き出す(言い換えない)
- 判断に迷ったら「迷い」列にYを付け、迷った理由を1行で書く
- 出力はCSV形式。列は 回答ID,カテゴリ,根拠の語句,迷い,迷いの理由
- 入力行数と出力行数が一致しているか、最後に報告する
「新しいカテゴリを作らない」と「根拠語句を原文から抜く」の2条件が重要です。これがないとカテゴリ名が揺れ、後で集計できません。
同じ依頼を2回実行して、結果が食い違った回答を「要確認」にするのも有効です(編集上の提案)。AIの出力は毎回同じとは限らないため、食い違いは定義のあいまいさを見つける手がかりになります。
手順4:人が確認して記録し、件数を集計する
AIが返した表を、そのまま集計に使わないでください。確認の範囲を、先に判断表で決めます。
- 「迷い」がYの回答、確認方法:全件を人が見て、確定カテゴリを書く
- 「その他」に入った回答、確認方法:全件を読み、新カテゴリが必要か判断する
- 2回の実行で食い違った回答、確認方法:全件を人が確認する
- 上記以外、確認方法:カテゴリごとに一定数(例:10件程度)を無作為に抜き出して確認する
抜き出し確認で誤りが目立つカテゴリは、定義を直して、そのカテゴリの回答を再分類します。
確認の結果は、次のような分類表に残します。
- R001、自由記述(原文):月額が高いと感じる、AI仮分類:価格、確定カテゴリ:価格、修正:―、修正理由:―
- R002、自由記述(原文):保存すると落ちるので欲しい機能以前の問題、AI仮分類:機能要望、確定カテゴリ:不具合、修正:○、修正理由:不具合の報告が主
(いずれも説明用の例です)
確定カテゴリができたら、件数を集計します。classified.csvに「回答ID」と「確定カテゴリ」の列があるものとします。
coded = pd.read_csv(
    "classified.csv", encoding="utf-8",
    dtype={"回答ID": str}, keep_default_na=False,
)
result = df.merge(coded[["回答ID", "確定カテゴリ"]], on="回答ID", how="left")
print("未分類", result["確定カテゴリ"].isna().sum())

counts = result["確定カテゴリ"].value_counts(dropna=False)
share = result["確定カテゴリ"].value_counts(normalize=True, dropna=False)
summary = pd.DataFrame({"件数": counts, "割合": share.round(3)})
summary.to_csv("summary.csv", encoding="utf-8-sig")
print(summary)
value_countsはnormalize=Trueで割合を返し、dropna=Falseで欠損も数に含めます。未分類の件数が0であることを、集計の前に必ず確認します。
集計表には次の注記を添えます。
- 分母(空欄を除いた回答数)と、除いた空欄の件数
- 主カテゴリ1つで数えたこと(複数カテゴリを数える場合は、合計が回答数を超えること)
- 分類した日付と、使ったコードブックの版
手順5:代表例を決まった基準で選ぶ
報告書に載せる代表例は、読み手に強い印象を与えます。そのため、「目を引いた回答」を選ぶと主観が入ります。基準を先に決めて、選定理由を記録します。
- 典型例、選び方:カテゴリの定義に最もよく合う回答、用途:カテゴリの意味を示す
- 境界例、選び方:「迷い」がYで、確認後に確定したもの、用途:分類基準の限界を示す
- ランダム例、選び方:乱数の種(シード)を記録して無作為に選ぶ、用途:偏りのない見本を示す
代表例の選定記録は次の形式にします。
- 価格、回答ID:R001、種類:典型例、選定理由:定義の語句をそのまま含む、加工:なし
- 不具合、回答ID:R002、種類:境界例、選定理由:要望と不具合が混在、主は不具合、加工:固有名詞を伏せ字
(説明用の例)
引用では原文を書き換えません。個人や会社が特定される部分だけ伏せ字にし、省略は「[…]」で示して、加工した事実を「加工」列に残します。
最後に保存しておくファイル
次の5点が揃えば、他の人が同じ手順をたどって結果を再確認できます。
- 原本CSV(未加工)
- コードブックと変更ログ
- 分類表(AI仮分類、確定カテゴリ、修正理由)
- 集計表と、分母・日付を書いた注記
- 代表例の選定記録